شیائومی و حل معمای تشخیص صدا در محیطهای شلوغ؛ CocktailASR-1 معرفی شد
شیائومی مدل متنباز CocktailASR-1 را معرفی کرد که میتواند صدای یک گوینده را از میان مکالمات چندنفره و محیطهای شلوغ جدا کند . هوش مصنوعی تکناک شیائومی این مشکل را «مشکل مهمانی کوکتل» مینامد. بیشتر مدلهای تشخیص گفتار زمانی که فقط یک نفر صحبت میکند، عملکرد…
خلاصه تحلیلی خبر
شیائومی مدل متنباز CocktailASR-1 را معرفی کرد که میتواند صدای یک گوینده را از میان مکالمات چندنفره و محیطهای شلوغ جدا کند . هوش مصنوعی تکناک شیائومی این مشکل را «مشکل مهمانی کوکتل» مینامد. بیشتر مدلهای تشخیص گفتار زمانی که فقط یک نفر صحبت میکند، عملکرد…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، مدل، CocktailASR-1، شیائومی، میکند
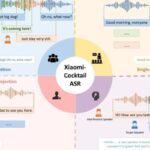
شیائومی مدل متنبازCocktailASR-1را معرفی کرد که میتواند صدای یک گوینده را از میان مکالمات چندنفره و محیطهای شلوغ جدا کند.
هوش مصنوعیتکناکشیائومی این مشکل را «مشکل مهمانی کوکتل» مینامد. بیشتر مدلهای تشخیص گفتار زمانی که فقط یک نفر صحبت میکند، عملکرد خوبی دارند، اما با همپوشانی چند صدا، شرایط بسیار دشوارتر میشود.
این وضعیت میتواند به تولید متن نامفهوم، ترکیب شدن جملهها یا نسبت دادن بخشهایی از مکالمه به گوینده اشتباه منجر شود.
این چالش شباهت زیادی به مشکلی دارد که شیائومی پیشتر با مدل تبدیل متن به گفتار OmniVoice به آن پرداخته بود.
بااینحال، CocktailASR-1 در جهت مخالف عمل میکند و بهجای تولید گفتار، صدای موردنظر را از میان صداهای مختلف جدا و رونویسی میکند.
CocktailASR-1 چگونه کار میکند؟
برای استفاده از CocktailASR-1، ابتدا باید یک فایل صوتی کوتاه از فردی که میخواهید صدای او را دنبال کنید، در اختیار مدل قرار دهید.
مدل از این فایل بهعنوان نمونه صوتی استفاده میکند و سپس در یک فایل ضبطشده با چند گوینده، صدای همان فرد را شناسایی و فقط صحبتهای او را رونویسی میکند.
شیائومی CocktailASR-1 را بر پایه معماری یکپارچه LLM توسعه داده است.
این شرکت میگوید مدل جدید در چندین بنچمارک تشخیص گفتار چندنفره، نتایج پیشرفتهای در سطح استانداردهای روز به دست آورده و از روشهای موجود برای انجام همین کار بهتر عمل کرده است.
این مدل فقط برای مکالمات گروهی و محیطهای پرسروصدا ساخته نشده است.
شیائومی میگوید CocktailASR-1 در شرایطی که تنها یک نفر صحبت میکند، تقریباً عملکردی مشابه مدلهای استاندارد تشخیص خودکار گفتار یا ASR دارد.
بنابراین کاربران برای دستیابی به عملکرد بهتر در فایلهای صوتی شلوغ، مجبور نیستند عملکرد مدل در تشخیص صدای یک گوینده را قربانی کنند.
CocktailASR-1 همچنین میتواند از حدسهای غیرضروری جلوگیری کند. اگر گوینده انتخابشده در فایل صوتی حضور نداشته باشد، مدل بهجای تلاش برای رونویسی صدای فرد دیگری، متن خالی برمیگرداند.
این مدل همچنین به حالت استدلال زنجیرهای یا Chain-of-Thought مجهز است. کاربران با استفاده از این قابلیت میتوانند استدلال مرتبط با فرایند رونویسی را مشاهده کنند و فقط نتیجه نهایی را دریافت نکنند.
بیشتر بخوانیدHyperOS 4 برای این ۷ گوشی شیائومی آزمایشی عرضه میشود
انتشار متنباز مدل جدید شیائومی
Xiaomi-CocktailASR-1 جدیدترین مدل از مجموعه مدلهای هوش مصنوعی شیائومی است که این شرکت آنها را بهصورت متنباز منتشر کرده است.
پیش از این، مدلهایی مانند MiMo-V2-Flash و Xiaomi Robotics-0 نیز از سوی شیائومی منتشر شده بودند.
CocktailASR-1 اکنون در GitHub و Hugging Face در دسترس توسعهدهندگان قرار گرفته است تا بتوانند این مدل را آزمایش و بررسی کنند.
بیشتر بخوانیدردمی واچ 6 لایت؛ ساعت هوشمند اقتصادی شیائومی با نمایشگر ۱۵۰۰ نیتی معرفی شد
نوشتهشیائومی و حل معمای تشخیص صدا در محیطهای شلوغ؛ CocktailASR-1 معرفی شداولین بار درTechnoc. پدیدار شد.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.