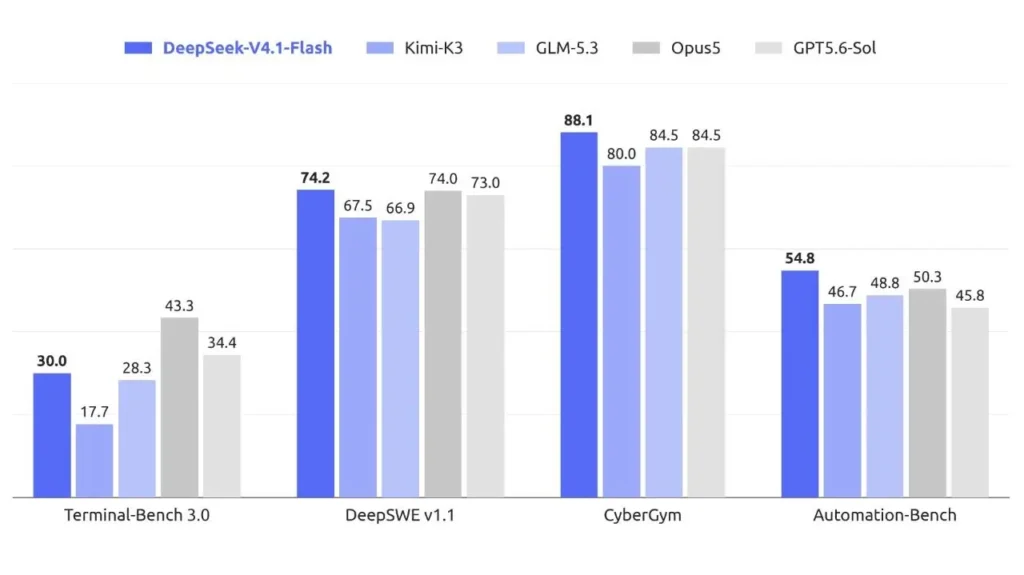
رونمایی دیپ سیک از مدل فوق سریع DeepSeek-V۴.۱-Flash با حافظه یک میلیون توکن و کاهش هزینه
دیپ سیک با رونمایی از مدل هوش مصنوعی DeepSeek-V4.1-Flash با معماری MoE و حافظه یک میلیون توکن، سرعت پردازش را افزایش و هزینهها را به شکل تاریخی کاهش داد. تحولات صنعت هوش مصنوعی در سال ۲۰۲۶ با شتابی باورنکردنی به سمت بهینهسازی زیرساختها حرکت میکند. در شرایط…
خلاصه تحلیلی خبر
دیپ سیک با رونمایی از مدل هوش مصنوعی DeepSeek-V4.1-Flash با معماری MoE و حافظه یک میلیون توکن، سرعت پردازش را افزایش و هزینهها را به شکل تاریخی کاهش داد. تحولات صنعت هوش مصنوعی در سال ۲۰۲۶ با شتابی باورنکردنی به سمت بهینهسازی زیرساختها حرکت میکند. در شرایط…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، مدل، حافظه، دیپ، میلیون
دیپ سیک با رونمایی از مدل هوش مصنوعیDeepSeek-V4.1-Flashبا معماریMoEو حافظه یک میلیون توکن، سرعت پردازش را افزایش و هزینهها را به شکل تاریخی کاهش داد.
تحولات صنعت هوش مصنوعی در سال ۲۰۲۶ با شتابی باورنکردنی به سمت بهینهسازی زیرساختها حرکت میکند. در شرایطی که شرکتهای بزرگ پیش از این روی آوردن بهارزش گذاری ۴۵ میلیارد دلاری دیپ سیکرا نشانهای از تغییر موازنه قدرت قلمداد میکردند، این مجموعه نوآور چینی نشان داد که جاهطلبیهای فنیاش مرزهای پیشبینی را درنوردیده است. بسیاری از کسبوکارها و مهندسان نرمافزار طی ماههای گذشته تمرکز خود را روینصب دیپ سیک به صورت آفلاین روی کامپیوترگذاشته بودند تا کنترل محلی و امنیت اطلاعات خود را حفظ کنند، اما عرضه نسخه ابری جدید همه معادلات کارایی را تغییر داد.
بر اساس دادههای رسمی که ساعاتی قبل دربیانیه رسمی شرکت دیپ سیکانتشار یافت، نسخه وی ۴.۱ فلش فقط یک مدل سریع معمولی نیست، بلکه پاسخی فناورانه به گرانترین بنبست صنعت یعنی حافظه موقت و تاخیر پردازشی در متون بسیار طویل است. مدیر فنی ارشد پروژه در جریان رونمایی زنده محصول تاکید کرد که ماموریت مدل فلش، دموکراتیک کردن هوش محاسباتی سنگین از طریق پایین آوردن توان مصرفی تراشهها به ازای هر خروجی مفید است. آمارهای منتشرشده نشان میدهند این مدل موفق شده تاخیر تولید اولین توکن را تا ۶۵ درصد نسبت به مدلهای رقیب در سناریوهای طولانی بکاهد و پایداری خروجی را به سطحی مثالزدنی برساند.
بازتعریف ترکیب متخصصان؛ قدرت نیم تریلیونی با مصرف یک مدل کوچک
قلب تپنده این دستاورد در مهندسی بازطراحیشده ساختار موسوم به Mixture of Experts نهفته است. مدل جدید در مجموع ۵۵۲ میلیارد پارامتر دارد، اما به لطف سامانه مسیریابی بسیار دقیق، در حین تولید و پیشبینی هر توکن تنها بین ۸ تا ۱۶ میلیارد پارامتر فعال میشوند. این ساختار مهندسی شده باعث میشود کاربر به دانش عمیق و منطق استدلالی یک ابرمدل عظیمالجثه دسترسی داشته باشد، در حالی که سرورهای پردازشی فشاری بیشتر از یک مدل جمعوجور و سبک متحمل نمیشوند.
در مدلهای سنتی، استفاده از پنجرههای بافت غولپیکر مساوی با اشغال سرسامآور حافظه و بالا رفتن سرسامآور تاخیر پاسخگویی بود. مدل جدید دیپ سیک این معادله فرسایشی را به گونهای دیگر بازنویسی کرده است. مهندسان این شرکت با پیادهسازی سازوکار توزیع دینامیک کار میان متخصصان شبکه عصبی، پردازشهای چندمرحلهای را بدون افت کیفیت زبان طبیعی به انجام میرسانند؛ دستاوردی که اجرای وظایف همزمان روی کلاسترهای محاسباتی را به مراتب ارزانتر و پایدارتر میسازد.
شکستن رکورد تاخیر با معماری نوآورانه و فوق سریع
ویژگی بارز دیگر این شاهکار مهندسی، پنجره بافت فوقالعاده با ظرفیت ۱ میلیون توکن است. تا پیش از این، ارسال فایلهای عظیم حاوی کدهای نرمافزاری پیچیده یا اسناد حقوقی و مالیاتی صدها صفحهای، باعث میشد کاربر دقایق طولانی به صفحه نمایش خیره بماند تا نخستین کلمات پاسخ شکل بگیرند. نسخه جدید این مانع بازدارنده را برداشته است. این مدل میتواند انبوهی از دادههای متنی، ساختار درختی کدها و اسناد پیدیاف را بخواند و تقریبا در لحظه به استخراج نکات بپردازد.
نکته متمایز این نسخه، چندرسانهای بودن بومی است. در معماریهای گذشته، ورودیهای تصویری ابتدا توسط یک شبکه کمکی به زبان متنی تبدیل میشدند و سپس وارد زنجیره محاسباتی میگشتند. در مدل جدید، پیکسلهای بصری و توکنهای متنی در یک فضای برداری مشترک همپوشانی دارند. این تحول یعنی مهندسان، پزشکان و تحلیلگران بازارهای مالی قادر خواهند بود تصاویر با وضوح بسیار بالا، نمودارهای زنجیرهای پیچیده و لاگهای سرور را در کنار توضیحات متنی بدون کوچکترین افت شناختی تحلیل کنند.
انقلابی در کاهش مصرف حافظه کش و پردازش همزمان
یکی از موانع اصلی در تجاریسازی ابزارهای هوش مصنوعی، هزینه بالای نگهداری بافت گفتگوها در حافظه موقت کارتهای گرافیکی بود. دیپ سیک ادعا کرده که با طراحی فرمولاسیون اختصاصی فشردهسازی لایهها، نیاز به حافظه KV Cache را تا ۷۵ درصد نسبت به نسخههای مرسوم کاهش داده است. این یعنی یک سرور واحد که قبلا میتوانست همزمان به پنجاه کاربر در متنهای حجیم سرویس دهد، اکنون قادر به میزبانی بیش از دویست مکالمه همزمان با همان منابع سختافزاری است.
این تحول نرمافزاری تاثیری شگرف روی توسعه سامانههای گفتگومحور و دستیاران هوشمند برخط میگذارد. رباتهایی که نیاز دارند حافظه مکالمات گذشته را هفتهها به یاد بسپارند یا دادههای راهنمای کاربر را مدام مرور کنند، دیگر باعث داغ شدن کلاسترهای پردازشی و اتمام پهنای باند حافظه نخواهند شد.
جدول مشخصات فنی و تحلیل تعرفههای خدمات دیپ سیک
| شاخص فنی یا مالی | مقدار اعلامشده در نسخه فلش | پیامد عملیاتی برای توسعهدهنده |
| مجموع پارامترهای مدل | ۵۵۲ میلیارد پارامتر MoE | عمق دانش وسیع و درک روابط ریاضی و منطقی پیچیده |
| پارامترهای فعال در هر توکن | ۸ تا ۱۶ میلیارد پارامتر | سرعت جهشیافته، تولید برق کمتر و تاخیر ناچیز |
| طول پنجره بافت ورودی | ۱ میلیون توکن | امکان پردازش همزمان چندین جلد کتاب یا کل ریپازیتوری کد |
| صرفهجویی در حافظه میانی کش | ۷۵ درصد کاهش | نگهداری کمهزینه تاریخچه نشستهای طولانی کاربران |
| نرخ ورودی هر میلیون توکن عادی | ۰.۳۰ دلار | افت چشمگیر مخارج اولیه در تحلیل دادههای سنگین متنی |
| نرخ ورودی در ساعات خلوتی | ۰.۱۵ دلار | بهترین نرخ در کل بازار برای پردازشهای دستهای شبانه |
| نرخ خروجی هر میلیون توکن عادی | ۱.۲۰ دلار | صرفهجویی اقتصادی بزرگ برای سامانههای تولید محتوا |
| نرخ خروجی در ساعات خلوتی | ۰.۶۰ دلار | ارزانتر شدن توسعه کارگزاران نرمافزاری مستقل |
| فراخوانی حافظه نهان یا Cache Hit | ۰.۰۰۶ دلار در میلیون توکن | تثبیت هزینهها در حد رایگان برای دادههای ثابت سازمانی |
شوک قیمتی به بازار؛ پایان دوران توکنهای گرانقیمت
سیاست مالی دیپ سیک را باید نوعی شبیخون ساختاری به جریانهای درآمدی سنتی پلتفرمهای غربی دانست. هنگامی که بهای هر میلیون توکن ورودی به ۳۰ سنت کاهش مییابد و در ساعات غیر اوج مصرف تا ۱۵ سنت افت میکند، توسعهدهندگان مستقل و استارتاپهای نوپا برای نخستین بار میتوانند سیستمهای بسیار پیشرفته را بدون نگرانی از ورشکستگی مالی راهاندازی کنند.
تصور کنید یک سامانه قضایی یا حقوقی قصد دارد روزانه هزاران پرونده مختومه را تحلیل و مستندسازی کند. با نرخ خیرهکننده ششهزارم دلار برای بازیابی اطلاعات از حافظه نهان، سازمانها میتوانند ساختارهای اطلاعاتی حجیم خود را تنها یک بار بارگذاری کرده و سپس با پرداخت رقمی نزدیک به صفر، در طول شبانهروز میلیونها پرسش و پاسخ تخصصی روی همان پروندهها انجام دهند. این صرفهجویی، دیوارهای انحصار را فروریخته و فضای رقابتی سال ۲۰۲۶ را به نفع نوآوری غیرمتمرکز دگرگون میسازد.
زنگ خطر دیپ سیک برای غول های سیلیکون ولی در سال ۲۰۲۶
تحلیلگران حوزه سیلیکون ولی مدتها بر این باور بودند که محدودیتهای تجاری و سختی دسترسی به تازهترین پردازندهها مانع جهشهای بزرگ در مدلهای متنباز آسیایی خواهد شد. با این حال، نسخه فلش با اثبات کارایی خارقالعاده روی منابع اقتصادی نشان داد که معماری هوشمندانه میتواند کمبود منابع سختافزاری خام را به حاشیه براند. وقتی یک مدل برای هر خروجی تنها به فعال بودن ۱۶ میلیارد پارامتر تکیه دارد، عملا به نیروی برق کمتر و خنککنندههای سادهتری نیاز خواهد داشت.
این رویداد شرکتهای پیشرو آمریکایی را در وضعیت انفعالی قرار میدهد. اکنون این غولها یا باید قیمتهای نجومی لایسنس مدلهای اختصاصی خود را به کف برسانند، یا نظارهگر کوچ گسترده توسعهدهندگان به زیرساختهای متنباز بهینهسازیشده باشند. بازخوردهای اولیه انجمنهای مهندسی نشان میدهد انعطاف این مدل در پاسخدهی به کدهای سیپلاسپلاس، پایتون و طراحی معماری میکروسرویسها بدون تاخیر خستهکننده، تحسین متخصصان ارشد را برانگیخته است.
آینده هوش مصنوعی با ابزارهای اقتصادی و فوق پرسرعت
رویکرد جدید دیپ سیک نشانهای قطعی از ورود به عصر کارگزاران تمامخودکار است. تا زمانی که هزینه هر فراخوانی بالا بود، واگذاری کارهای طولانی چندمرحلهای به دستیاران هوشمند ریسک مالی بزرگی تلقی میشد. اکنون با نرخ خروجی ۶۰ سنتی در ساعات خلوت شبانه، میتوان شبکهای از دهها کارگزار هوشمند مستقل تشکیل داد که به شکل پیوسته به نوشتن تست، پایش باگها، پاسخ به تیکتهای پشتیبانی مشتریان و دستهبندی اسناد بپردازند.
در مجموع، رونمایی از این محصول گام بلندی برای رسیدن به پردازشهای آنی و ارزان به شمار میآید. کاهش هفتاد و پنج درصدی فشار روی سختافزار سرور در کنار پنجره متنی یک میلیونی، آغازگر موج جدیدی از برنامههای تعاملی و بیدرنگ در سطح وب خواهد بود. تیمی که زمانی با جسارت پایههای استقلال فنی خود را بنا نهاد، امروز استانداردهای سرعت و بازدهی مالی اکوسیستم جهانی را بازتعریف کرده است.
سوالات متداول
این مدل هوشمند با فعال کردن ۸ تا ۱۶ میلیارد پارامتر در هر گام سرعت پاسخ را بسیار بالا برده و مصرف منابع سرورها را به شدت کاهش داده است.
این ویژگی کاربردی اجازه میدهد دهها کتاب و پروژههای بسیار بزرگ نرمافزاری همراه تصاویر بدون خرد کردن دادهها به صورت یکجا تحلیل گردند.
صرفهجویی ۷۵ درصدی در حافظه سبب میشود همزمان صدها کاربر مختلف بدون افت شتاب پردازش بتوانند مکالمات طولانی کاری خود را به آسانی حفظ کنند.
ورودی هر ۱ میلیون توکن از ۰.۱۵ تا ۰.۳۰ دلار و خروجی آن از ۰.۶۰ تا ۱.۲۰ دلار محاسبه گشته و بازیابی حافظه کش هم فقط ۰.۰۰۶ دلار تمام میشود.
بله این مدل فایلهای تصویری را بدون نرمافزار کمکی و به صورت کاملا بومی درون لایههای شبکه عصبی خود در کنار دادههای متنی پردازش میکند.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.