مدل هوش مصنوعی Qwen۳.۸-LiveTranslate معرفی شد؛ ترجمه زنده ۶۰ زبان با تاخیر ۲.۳ ثانیه
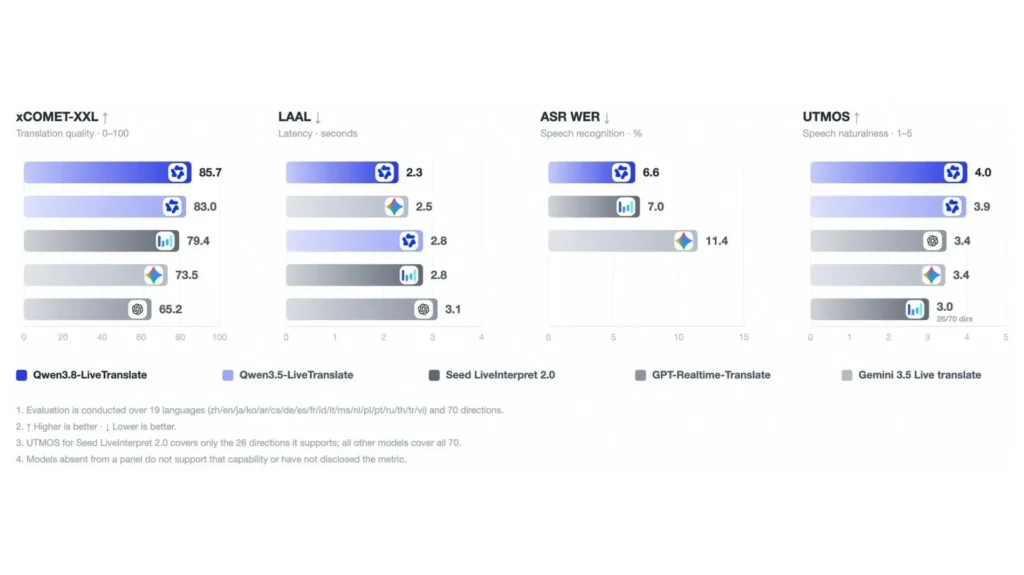
Qwen3.8-LiveTranslate مدل مترجم همزمان علیبابا است که با تاخیر شگفتانگیز ۲.۳ ثانیه در ۶۰ زبان، امکان تفکیک صدای چند گوینده و رفع ابهام معنایی را فراهم میکند. تیم هوش مصنوعی علیبابا با پشتوانه دستاوردهای پیشین خود در توسعه مدل پیشرفته چندوجهی کیوون این بار…
خلاصه تحلیلی خبر
Qwen3.8-LiveTranslate مدل مترجم همزمان علیبابا است که با تاخیر شگفتانگیز ۲.۳ ثانیه در ۶۰ زبان، امکان تفکیک صدای چند گوینده و رفع ابهام معنایی را فراهم میکند. تیم هوش مصنوعی علیبابا با پشتوانه دستاوردهای پیشین خود در توسعه مدل پیشرفته چندوجهی کیوون این بار…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، زبان، میکند، صدای، تاخیر
Qwen3.8-LiveTranslate مدل مترجم همزمان علیبابا است که با تاخیر شگفتانگیز ۲.۳ ثانیه در ۶۰ زبان، امکان تفکیک صدای چند گوینده و رفع ابهام معنایی را فراهم میکند.
تیم هوش مصنوعی علیبابا با پشتوانه دستاوردهای پیشین خود در توسعهمدل پیشرفته چندوجهی کیووناین بار گامی بزرگ در جهت پیوند دادن جوامع زبانی برداشته است. این فناوری تازه به گونهای مهندسی شده که شکاف ارتباطی میان زبانهای مختلف را در جلسات زنده، مصاحبهها و رویدادهای چندزبانه پر کند. اگر در سالهای گذشته تاخیر چند ثانیهای و ترجمههای خشک کلمهبهکلمه مکالمات بینالمللی را به فرآیندی خستهکننده تبدیل میکرد، حالا الگوریتمهای بلادرنگ مرزهای زبان را جابهجا کردهاند.
طبق بیانیه تازهای که درحساب رسمی تیم کیوون در شبکه ایکسانتشار یافته، رویکرد پردازش خطبهخط جای خود را به تحلیل زنجیرهای پیوسته داده است. بر اساس گزارشهای فنی، دقت سیستم در انتقال معنا بیش از ۲۸ درصد در مقایسه با استانداردهای متنباز پیشین بهبود داشته و مکالمات روزمره به شکلی روان به گوش شنونده میرسند. این جهش بزرگ نشاندهنده تغییر جهت صنعت از ابزارهای تبدیل صوت به متن سنتی به سوی موتورهای یکپارچه درک گفتار است.
کالبدشکافی معماری صوتی و شکستن رکورد سرعت تاخیر کلامی
بزرگترین مانع پیش روی مترجمهای بلادرنگ در سالهای اخیر، زمان لازم برای گوش دادن، رونویسی، ترجمه متن و در نهایت تولید دوباره صدا بوده است. مدل تازه معرفیشده علیبابا با ادغام این مراحل در یک بستر واحد، زمان انتظار را به ۲.۳ ثانیه کاهش داده است. این یعنی وقتی یک شخص سخن میگوید، ترجمه گفتار او با کمترین فاصله زمانی ممکن به گوش مخاطب مقابل میرسد. این دستاورد بر پایه اسناد منتشرشده درپایگاه اطلاعرسانی علیبابا کلودحاصل یک بهینهسازی دقیق در لایههای مدل تبدیل امواج صوتی است.
لین جون، مهندس ارشد بخش پردازش گفتار در تیم پژوهشی این پروژه درباره این تحول اعلام کرد که هدف اصلی تیم، حذف لایههای واسطه ناکارآمد و رسیدن به ترجمهای بود که ریتم ارگانیک سخن گفتن انسان را مختل نکند. این هماهنگی موجب شده شنوندگان دیگر سکوتهای ناشی از بارگذاری سرورها را حس نکنند و مکالمه حالتی روان و کاملا طبیعی پیدا کند.
| مولفه فنی | مشخصات نسخه جدید | استانداردهای مرسوم بازار |
| تاخیر نهایی پاسخ | ۲.۳ ثانیه | ۴.۵ تا ۶ ثانیه |
| تعداد زبانهای تحت پوشش | ۶۰ زبان با لحن طبیعی | ۳۰ تا ۴۰ زبان تجاری |
| تفکیک چند گوینده همزمان | پشتیبانی کامل همراه با شبیهسازی صدا | نیازمند مکث گویندگان و تکصدایی |
| قابلیت تطبیق معنایی | پایش متن مکالمه از ابتدای صحبت | پایش حداکثر جمله قبلی |
| نمایش متن بصری | زیرنویس دوزبانه کاملا همگام | زیرنویس تاخیری یا تکزبانه |
کاهش تاخیر بدون افت کیفیت واژگان از مهمترین اولویتها در طراحی چنین سیستمی به شمار میرود. پژوهشگران برای رسیدن به این نرخ پاسخدهی، بخش تحلیل امواج صوتی را مستقیما به رمزگذار زبانی متصل کردهاند تا دادهها پیش از به پایان رسیدن جمله سخنگو پردازش شوند. این طراحی از انباشت دادههای صوتی در حافظه موقت جلوگیری میکند و پردازش ابری را به شدت کمهزینهتر میسازد.
تفکیک هوشمندانه گویندگان و برچیده شدن خطاهای واژگانی
یکی از چالشهای همیشگی در مکالمات گروهی، همپوشانی صدای شرکتکنندگان بود. زمانی که چند نفر در یک میزگرد همزمان صحبت میکردند، سامانههای ترجمه با سردرگمی شدید مواجه میشدند و پیامها را در هم میآمیختند. سیستم حاضر به قابلیت تفکیک گویندگان مجهز شده است که اجازه میدهد صداهای درهمآمیخته جداسازی شوند. سیستم نه تنها متوجه تفاوت افراد میشود، بلکه صدای ترجمهشده را متناسب با فرکانس و جنس صدای گوینده بازتولید میکند.
به کارگیری شبیهسازی صدای طبیعی باعث میشود دیگر صدای ماشینی و بیروح گذشته شنیده نشود. شنونده بدون نگاه کردن به نمایشگر متوجه میشود که چه کسی در حال صحبت کردن است. این ویژگی برای کنفرانسهای بینالمللی تجاری، سمینارهای علمی آنلاین و تلهمدیسین اهمیتی حیاتی دارد، زیرا احساس همدلی میان طرفین گفتگو را حفظ میکند.
قابلیت مهم دیگر، نمایش همزمان دو زبان روی صفحه است. کاربر میتواند همانطور که واژگان ترجمهشده را میشنود، متن زبان اصلی و برگردان آن را روی نمایشگر خود در قالب زیرنویسهای لحظهای بررسی کند. این امر به کاهش سوءتفاهمها کمک فراوانی میکند و اجازه میدهد کاربران مسلط به زبان دوم نیز نکات فنی را سریعتر ارزیابی کنند.
سیستم همچنین با مرور تاریخچه مکالمه، به رفع ابهام از اصطلاحات تخصصی و اسامی خاص میپردازد. اگر کلمهای در چند زمینه گوناگون معانی متفاوتی داشته باشد، موتور هوشمند بر اساس جملاتی که دقایقی قبل گفته شده، معنای مناسب را انتخاب میکند. در تستهای تخصصی، این روش خطای نامگذاری افراد، اسامی شرکتها و عبارات تجاری را تا ۴۰ درصد نسبت به سیستمهای واژهبهواژه پایین آورده است.
کاربردهای عملیاتی در ابعاد گوناگون فناوری
پشتیبانی گسترده از شصت زبان مختلف، جهان کسبوکار را به شکلی محسوس متحول میسازد. پلتفرمهای خدمات مشتریان در سراسر قارهها با بهکارگیری چنین مدلی میتوانند پاسخگویی تلفنی و تصویری را بدون نیاز به مترجمان انسانی متعدد فراهم کنند. یک مهندس در ژاپن میتواند بدون نگرانی از موانع زبانی، با همتای آلمانی یا برزیلی خود پیرامون کدهای فنی بحث کند و پاسخها را بیدرنگ بشنود.
در حوزه سلامت و اورژانس نیز این دستاورد نجاتبخش خواهد بود. تیمهای امدادی بینالمللی در بحرانهای طبیعی زمان اندکی برای یافتن مترجم دارند. استفاده از تبلتها و تلفنهای هوشمند مجهز به این معماری، گفتگو با آسیبدیدگان را در سریعترین زمان ممکن و با دقت فراوان میسر میکند.
صنعت سرگرمی و پخش زنده مسابقات ورزشی یکی دیگر از بسترهای بزرگ برای بهرهبرداری از این دستاورد است. تولیدکنندگان محتوا و استریمرها قادر خواهند بود به طور زنده با مخاطبان خود در هر گوشهای از کره زمین سخن بگویند و محتوای صوتی با زبان محلی مخاطب برای او بازپخش شود.
جایگاه ابزارهای ترجمه بلادرنگ در افق ارتباطات ۲۰۲۶
تحولات دنیای هوش مصنوعی در سال جاری میلادی گویای این حقیقت است که رابطهای صوتی جایگاه ویژهای یافتهاند. دیگر صفحه کلید تنها راه ارتباط انسان با رایانه نیست و سرعت در پردازش کلامی حرف اول را میزند. رقابت میان غولهای فناوری شرق و غرب به نقطهای رسیده که کیفیت، تاخیر و کاهش مصرف منابع سرور، خطمشی اصلی بقا در بازار است.
با توجه به انتشار گستردهتر این دستاوردها، به زودی شاهد فراگیر شدن ابزارهای ترجمه درون هدفونهای بیسیم، عینکهای هوشمند و برنامههای پیامرسان خواهیم بود. از میان برداشته شدن معطلیهای مکالمه صوتی، گامی نمادین در رسیدن به ارتباطات فراگیر جهانی به حساب میآید. این مدل نشان داد که ترکیب سرعت بالا با درک مفهومی و تفکیک انسانی، دیگر یک رویای دوردست نیست بلکه واقعیتی قابل پیادهسازی روی پلتفرمهای امروزی به شمار میرود.
سوالات متداول
تاخیر ترجمه به ۲.۳ ثانیه رسیده که ارتباط کلامی بدون مکث را میان گویندگان در جلسات کاری ممکن میسازد.
بله این سیستم صدای افراد مختلف را به طور دقیق تفکیک کرده و لحن هر گوینده را بازتولید میکند.
نسخه جدید از شصت زبان گوناگون پشتیبانی کرده و خطاهای معنایی عبارات محلی را کاهش داده است.
سامانه با تکیه بر تاریخچه گفتگو اصطلاحات تخصصی و نامها را تحلیل و ابهامزدایی میکند.
این معماری به شکل متنباز و رابط ابری در دسترس پژوهشگران سراسر جهان قرار گرفته است.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.