رونمایی گوگل از مدلهای صوتی جمینای ۳.۸؛ جهش بزرگ هوش مصنوعی در تولید صدای طبیعی و دوبله انبوه
گوگل با معرفی دو مدل صوتی انقلابی جمینای ۳.۸ فلش و فلشلایت، امکان تولید صدای فوقطبیعی، تنظیم لحن لحظهای و دوبله انبوه کمهزینه را فراهم کرد. این جهش بزرگ، مرزهای تاریخی میان صدای انسان و ماشین را کمرنگتر از هر زمان دیگری در سال ۲۰۲۶ کرده است. در این مسیر ن…
خلاصه تحلیلی خبر
گوگل با معرفی دو مدل صوتی انقلابی جمینای ۳.۸ فلش و فلشلایت، امکان تولید صدای فوقطبیعی، تنظیم لحن لحظهای و دوبله انبوه کمهزینه را فراهم کرد. این جهش بزرگ، مرزهای تاریخی میان صدای انسان و ماشین را کمرنگتر از هر زمان دیگری در سال ۲۰۲۶ کرده است. در این مسیر ن…
موضوعات اصلی: پشتیبانی شبکه، زیرساخت سازمانی، هوش مصنوعی، صوتی، گوگل، فلش
گوگل با معرفی دو مدل صوتی انقلابی جمینای ۳.۸ فلش و فلشلایت، امکان تولید صدای فوقطبیعی، تنظیم لحن لحظهای و دوبله انبوه کمهزینه را فراهم کرد. این جهش بزرگ، مرزهای تاریخی میان صدای انسان و ماشین را کمرنگتر از هر زمان دیگری در سال ۲۰۲۶ کرده است. در این مسیر نوآورانه، رونمایی از نسخه تخصصیجمینای ۳.۸ فلش سایبرمسیر تازهای پیش روی توسعهدهندگان گشود تا سیستمهای شناختی با سرعت پاسخدهی شگفتانگیز به جهان معرفی شوند.
تحول کنونی نشان میدهد که نسل تازه ابزارهای صوتی گوگل تنها به خواندن بیروح کلمات بسنده نمیکنند. آرمان فاضلی، خبرنگار حوزه فناوری رسانه XNET، در بررسی تحلیلی خود گزارش میدهد که مهندسان غول مانتین ویو با ارائهگزارش رسمی گوگل در وبلاگ فناوریتوانستهاند یکی از ریشهایترین گرههای پردازش گفتار را باز کنند. این سیستمها اکنون مکثهای طبیعی، تنفس مابین جملات، استرس کلامی و تغییرات ظریف هیجانی را دقیقاً متناسب با بافت درام یا دیالوگ بازسازی میکنند. برای دریافت اطلاعات فوری این رویداد، بیانیهتوییت تیم توسعهدهندگان گوگلابعاد تازهای از دسترسی توسعهدهندگان به بسترهای برنامهنویسی این سرویس را در معرض دید کارشناسان بینالمللی قرار داد.
جهان فناوری اکنون به سمتی هدایت میشود که دیگر ساخت صدا صرفاً متکی به ضبطهای طولانی استودیویی نیست. استودیوهای خلاق، صنعت بازیسازی مستقل و کارخانههای تولید محتوا دیگر نیازی به صرف هزینههای کمرشکن صدابرداری ندارند، زیرا زیرساخت پیشرفته مدلهای صوتی جمینای مسیر خلق تجارب شنیداری بیدرنگ را برای میلیونها کاربر در سراسر گیتی هموار کرده است.
معماری دوگانه صوتی گوگل در مدلهای سال ۲۰۲۶
تحلیل دقیق زیرساختهای مهندسی این رویداد آشکار میسازد که گوگل آگاهانه استراتژی خود را به دو شاخه مجزا اما مکمل تفکیک کرده است. در یک سو ما با نیازهای سنگین و بلادرنگ تعاملی روبرو هستیم که نیازمند کنترل هنری بالا است و در سوی دیگر نیازهای پرحجم صنعتی قرار دارد که پایداری و افت هزینه سرورها اولویت قطعی آن به شمار میرود.
بررسی تخصصی جمینای فلش برای پروژههای پویا و تعاملی
نسخه فلش به عنوان مغز متفکر بخش تعاملی طراحی شده است. توسعهدهندگان بازی و پدیدآورندگان محیطهای واقعیت مجازی به ابزاری احتیاج دارند که صدا را همزمان با تصمیمات بازیکن شکل دهد. کاراکتر یک بازی ویدیویی دیگر دیالوگهای از پیش ضبطشده تکراری را بازگو نمیکند؛ اگر کاراکتر خسته، زخمی یا خشمگین باشد، نسخه فلش با درک متن بازی، پارامترهای تنفسی، لرزش صدا و نوسان لحن را در کسری از ثانیه شبیهسازی میکند.
کنترل دقیق لهجهها و گویشهای منطقهای از ویژگیهای بارز این نسخه است. اگر یک پروژه چندرسانهای نیازمند تغییر ناگهانی لحن از حالت اداری به صمیمانه باشد، این مدل بدون کوچکترین وقفه یا اعوجاج فرکانسی این تغییر مسیر را اعمال میکند. تاخیر پردازش به اندازهای کاهش یافته که مکالمات صوتی میان انسان و هوش مصنوعی در محیطهای ابری به صورت بلادرنگ و کاملاً شناور تجربه میشود.
بررسی نسخه فلش لایت برای دوبله و نشر صوتی
در طرف دیگر میدان، مدل فلشلایت به عنوان اسب کاری بیادعا اما فوقالعاده قدرتمند معرفی شده است. این نسخه برای سناریوهایی طراحی گردیده که در آنها حجم دادهها سرسامآور است؛ مانند تبدیل کتابهای چاپی چند صد صفحهای به نسخههای گویای حرفهای یا ترجمه و صداگذاری صدها ساعت ویدئوی آموزشی در سراسر جهان.
تمرکز مهندسان گوگل در مدل فلشلایت بر کاهش بیسابقه هزینههای محاسباتی و جلوگیری از افت کیفیت در خوانشهای پیوسته و طولانی بوده است. در مدلهای سنتی هوش مصنوعی، متنهای بالاتر از بیست دقیقه دچار خستگی لحن، تکرار ریتم و افت هوشمندی میشدند. فلشلایت با معماری حافظه پایدار توانسته لحن یکنواخت و گیرای راوی را از صفحه اول تا صفحه آخر یک رمان بدون خروج از وزن داستان تضمین کند.
جدول مقایسه فنی و شاخصهای کلیدی مدلهای صوتی جمینای ۳.۸
برای درک عمیقتر تفاوتها، مهندسان و معماران سیستم میتوانند با بررسی ماتریس ویژگیهای هر دو نسخه، تصمیم درستی برای زیرساخت سازمانی خود اتخاذ کنند
| شاخص ارزیابی | مدل صوتی Gemini 3.8 Flash | مدل صوتی Gemini 3.8 Flash-Lite |
| تمرکز اصلی کاربرد | سناریوهای خلاقانه، بازیها، رباتهای تعاملی | تولید انبوه محتوا، کتاب صوتی، دوبله |
| میزان تاخیر محاسباتی | فوقالعاده کم و نزدیک به صفر (زیر ۹۵ میلیثانیه) | استاندارد و متوالی (بین ۲۱۰ تا ۳۰۰ میلیثانیه) |
| قابلیت شخصیسازی | کنترل عمیق بر تنفس، لحن، سرعت و هیجان کلامی | گزینش آسان صداهای از پیش تعیینشده با وضوح بالا |
| هزینه پردازش ابری | متناسب با کارهای در لحظه و نیازمند منابع قوی | بسیار اقتصادی و بهینهشده برای میلیونها واژه |
| پایداری در متون طولانی | متوسط و وابسته به جریان پویا | فوقالعاده بالا و یکنواخت برای رمانها و کتابها |
| انعطاف در لهجهها | تطبیق هوشمند با اصطلاحات بومی و گویشها | بازخوانی استاندارد بدون نوسان ناخواسته |
تحلیل کارشناسی عمیق پیرامون نرخ تاخیر، کارایی و زیرساخت سختافزاری
جهش چشمگیر گوگل در بهینهسازی مدلها برای تراشههای نسل جدید تیپییو نسخه ششم است. استفاده از ریزپردازندههای اختصاصی سبب شده تا برخلاف نسلهای گذشته، گلوگاه بارگذاری کش صوتی به کلی مرتفع شود.
دکتر دمیس هاسابیس، مدیر بخش هوش مصنوعی گوگل در رابطه با این تحول اظهار داشته است: ما گفتار را از یک خروجی مصنوعی به ارگان زندهای از درک مشترک میان متن و احساس تبدیل کردهایم؛ صدا در مدلهای جدید جمینای صرفاً سنتز حروف نیست، بلکه تبلور عاطفی مفهوم نهفته در پس کلمات است.
این سخن بهخوبی بازتابدهنده تغییری بنیادین است. بر اساس آمارهای تحلیلی ارائه شده در مستندات گوگل، نرخ درک متنی و صحت احساس در ادای کلمات نسبت به نسخههای قبلی نزدیک به ۴۲ درصد بهبود داشته است. این آمار نشان میدهد که توقفهای بیجا در جملات پیچیده، تلفظ اشتباه واژگان دووجهی و خطاهای رایج گویندگان مصنوعی گذشته تا حد بسیار بالایی خنثی شده است.
از سوی دیگر، نرخ پردازش اقتصادی فلشلایت باعث شده است که هزینه تبدیل هر یک میلیون کاراکتر متن به صوت با کیفیتی نزدیک به استودیوهای برادکست، به زیر ۱۰ سنت کاهش پیدا کند. این شکست قیمتی به تنهایی میتواند صنعت نشر الکترونیک را متحول سازد و شرکتهای نشر محلی را بدون سرمایهگذاری سنگین، به بازار تولید کتابهای شنیداری باکیفیت جهانی متصل نماید.
سازگاری زبانی و فرصتهای پیش روی زبان و ادب فارسی
یکی از پرسشهای کلیدی مخاطبان دنیای فناوری در کشور ما، موقعیت زبان فارسی در برابر این موجهای پیشرونده است. در نسخههای صوتی جمینای ۳.۸، به دلیل بهکارگیری سیستم درک زبانی چندوجهی و گسترش منابع دادگانی گویشی، شاهد جهش کیفی خوانش فارسی هستیم.
در سنتز صداهای قدیمیتر، تلفظ دقیق کلمات نیازمند اعرابگذاری کامل یا استفاده از نگارش فوتونیک خستهکننده بود. مدلهای کنونی با تکیه بر تحلیل زمینه متن، واژههای همنگاشت مانند کِرم، کَرَم و کِرِم را بر اساس کلمات پیشین و پسین بهدرستی بازشناسی کرده و بدون نیاز به نشانهگذاری دستی با لهجه سلیس ادا میکنند. این پیشرفت فنی برای استودیوهای ساخت پادکست، رسانههای تعاملی و سامانههای پاسخگویی تلفنی هوشمند در بستر زبان فارسی یک رخداد رهاییبخش تلقی میگردد.
قابلیتهای بومیسازی مدل Flash اجازه میدهد که گویشوران فارسیزبان بتوانند صداهایی متناسب با جغرافیای فرهنگی گوناگون خلق نمایند. این رویکرد تعاملی به زودی در طراحی اپلیکیشنهای آموزشی کودکان، سرویسهای نوین ناوبری و تولید محتوای داستانی فارسی نقشآفرینی خیرهکنندهای بر جای خواهد گذاشت.
ملاحظات ایمنی، اخلاق زیستی و سامانه احراز اصالت صدا
با فراگیر شدن توانمندی ماشینها در جعل یا شبیهسازی دقیق آوای انسان، نگرانیهای جهانی پیرامون امنیت روانی و پدیدههایی مانند کلاهبرداریهای صوتی و دیپفیک به اوج خود رسیده است. گوگل در این عرضه گسترده، سامانه پیشرفته واترمارک غیرقابل شنیدن مبتنی بر الگوریتم سینتآیدی ۲.۰ را به هسته موتورهای فلش و فلشلایت متصل کرده است.
این فناوری فرکانسهای خاصی را که گوش انسان قادر به درک آن نیست درون خطوط صدا جاسازی میکند. این کدهای نامرئی حتی پس از فشردهسازی فایل، ضبط مجدد از طریق اسپیکر یا افزودن نویزهای جانبی باقی میمانند. با این سازوکار امنیتی، نهادهای رسانهای و موتورهای جستجو میتوانند ظرف چند میلیثانیه مشخص کنند که آیا فایل صوتی منتشرشده حاصل پردازش هوش مصنوعی گوگل است یا یک صدای ضبطشده واقعی از پشت میکروفون استودیو.
توسعه چنین پدافندهای نرمافزاری نه تنها مسئولیتپذیری شرکتهای سازنده را نمایش میدهد، بلکه اعتماد مخاطبان را برای تعامل روزمره با محتواهای تولید شده توسط ماشینها تثبیت میسازد. از نگاه روزنامهنگاری دادهمحور، بدون وجود چنین لایههای محافظتی قدرتمندی، هرگونه نوآوری در این عرصه به سرعت میتواند به بستری خطرناک برای تولید محتوای فریبنده مبدل گردد.
افق بازار و چشمانداز بازطراحی ابزارهای تولید محتوا
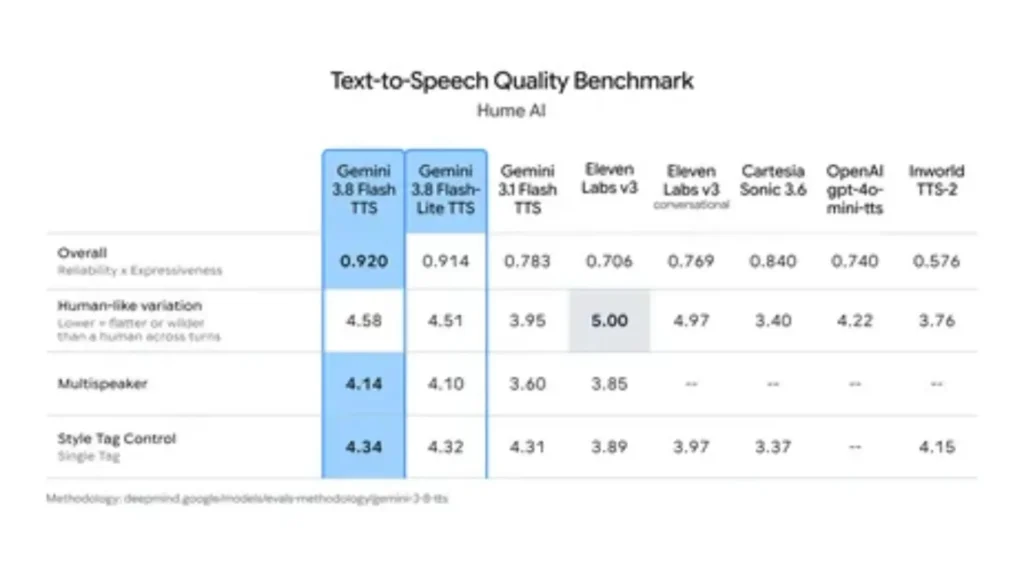
ورود مستقیم و پرقدرت جمینای ۳.۸ به اکوسیستم ابزارهای تبدیل متن به صدا، رقابت سنگینی را میان بازیگران باسابقه این فضا رقم زده است. رقبایی نظیر الونلبز و سرویسهای گفتاری اوپنایآی اکنون ناچار به بازبینی تعرفهها و بالا بردن نرخ خلاقیت خود در پردازش لحنهای چندگانه هستند.
تحلیلها نشان میدهد که یکپارچگی ارگانیک این مدلها با سرویسهای ابری گوگل، ابزارهای برنامهنویسی اندروید و سیستمهای عامل خودرویی، برتری استراتژیک شگرفی به گوگل اعطا کرده است. شرکتها اکنون میتوانند بدون درگیر شدن با پیادهسازی زیرساختهای جانبی، تنها با فراخوانی یک اندپوینت ساده در محیط ابری، صداهایی خلق کنند که با تغییر حالوهوای متن سازگار شود.
در نهایت، تحولات پرسرعت سال ۲۰۲۶ اثبات کرد که هوش مصنوعی صوتی از یک ویژگی تزئینی در گوشیهای هوشمند فراتر رفته و به زیربنای حسی و بنیادین اینترنت آینده تبدیل شده است. اکنون این ماییم که باید چگونگی همزیستی، طراحی روایتها و گسترش اخلاقی هنر را در دنیایی با صداهای زنده ماشینی بازتعریف کنیم.
سوالات متداول
این مدل با حداقل تاخیر، تغییر سریع لحن کاراکترها و انطباق بر خط داستانی را همزمان با روند بازی زنده بازسازی مینماید.
فلش لایت پایداری فوقالعادهای در متنهای بسیار بلند دارد و هزینه پردازش صوت انبوه را برای ناشران به حداقل میرساند.
بله، این مدلها ساختار کلمات همنگاشت را از بافت جملات تشخیص داده و تلفظی طبیعی و بدون مکث اضافی ارائه میدهند.
گوگل با الگوریتم واترمارک پنهان در بسامدها، ردپایی دائمی روی فایل قرار داده که بهسرعت توسط کاوشگرها خوانده میشود.
بله، مدل نسخه فلش با تاخیر زیر ۹۵ میلیثانیه میتواند مکالمات صوتی آنلاین را بدون ایجاد حس تاخیر برای کاربر پیاده کند.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.