تفاوت مدلهای زبانی کوچک و بزرگ؛ تحلیل جامع عملکرد هوش مصنوعی آفلاین روی گوشیهای
مدل زبانی کوچک یا همان اسالام سیستمی فشرده با پارامترهای محدود است که محاسبات خود را مستقیما روی تراشه گوشی تلفن همراه و بدون نیاز به اینترنت انجام میدهد. در نقطه مقابل، مدل زبانی بزرگ یا الالام ساختاری با صدها میلیارد پارامتر دارد که در دیتاسنترهای عظیم…
خلاصه تحلیلی خبر
مدل زبانی کوچک یا همان اسالام سیستمی فشرده با پارامترهای محدود است که محاسبات خود را مستقیما روی تراشه گوشی تلفن همراه و بدون نیاز به اینترنت انجام میدهد. در نقطه مقابل، مدل زبانی بزرگ یا الالام ساختاری با صدها میلیارد پارامتر دارد که در دیتاسنترهای عظیم…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، مدلهای، مدل، زبانی، بدون
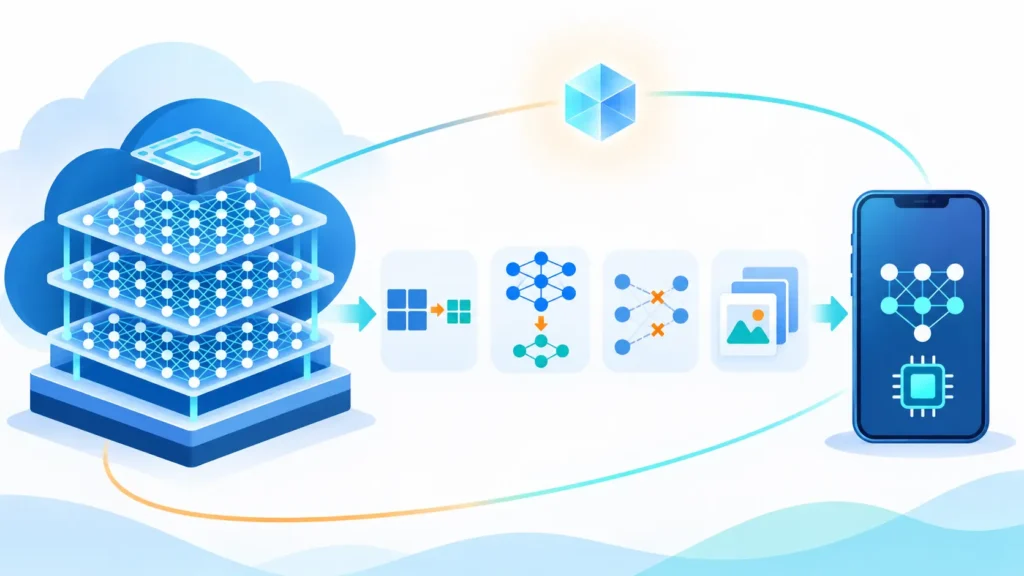
مدل زبانی کوچک یا همان اسالام سیستمی فشرده با پارامترهای محدود است که محاسبات خود را مستقیما روی تراشه گوشی تلفن همراه و بدون نیاز به اینترنت انجام میدهد. در نقطه مقابل، مدل زبانی بزرگ یا الالام ساختاری با صدها میلیارد پارامتر دارد که در دیتاسنترهای عظیم پردازش میشود؛ بنابراین تفاوت بنیادین آنها در محل استقرار، سرعت پاسخ، حفظ امنیت دادهها و میزان مصرف منابع سختافزاری است.
با پیشرفت تراشههای مجهز به پردازنده عصبی در سال ۲۰۲۶، دیگر فرستادن تمام درخواستهای متنی به سرورهای ابری منطقی به نظر نمیرسد. کاربر وقتی میخواهد متنی را خلاصه کند یا پاسخی سریع برای یک پیام بنویسد، انتظار دارد گوشی او در همان لحظه و بدون وابستگی به وضعیت شبکه اینترنت خروجی را تولید کند. چنین نیازی باعث شده تا مرزبندی میانمدلهای زبانی بزرگکه پردازشهای دوردست را پوشش میدهند بامدلهای زبانی کوچککه درون حافظه رم گوشی زندگی میکنند، آشکارتر از هر زمان دیگری در دنیای فناوری دنبال شود.
مدل زبانی کوچک چیست و چگونه به گوشیهای همراه رسید؟
برای سالهای طولانی چنین تصور میشد که مدلهای هوش مصنوعی تنها زمانی معنا پیدا میکنند که ابعاد آنها به دهها یا صدها میلیارد پارامتر برسد. سیستمهای اولیه نیازمند فارمهای پردازشی متشکل از هزاران تراشه گرافیکی بودند و برق بسیار زیادی مصرف میکردند. این وابستگی موجب شد تا ابزارهای اولیه هوش مصنوعی همیشه با تاخیر شبکه، صف انتظار سرورها و خطر همیشگی افشای دادههای شخصی همراه باشند.
تغییر مسیر مهندسی با ورود روشهای بهینهسازی پارامتر آغاز شد. متخصصان متوجه شدند حجم زیادی از اتصالات در یک شبکه ترانسفورمر بزرگ کارکرد روزمره ندارند یا دادههای زائد اینترنتی را به دوش میکشند. با تصفیه مجموعه دادههای آموزشی و تمرکز بر متون تخصصی، مدلهایی خلق شدند که ابعاد آنها معمولا بین یک تا هفت میلیارد پارامتر است. این سایز فشرده به مدل اجازه میدهد روی چند گیگابایت از رم یک تلفن همراه پرچمدار یا میانرده بدون افت سرعت سیستمعامل بارگذاری شود و بدون نیاز به سرور به کار خود ادامه دهد.
تفاوتهای بنیادین در معماری؛ مقیاس پارامترها و نحوه فشردهسازی
هنگامی که درباره مقیاس یک سیستم هوش مصنوعی صحبت میشود، تعداد پارامترها نشاندهنده وزنها و اتصالاتی است که مدل در طول دوران یادگیری ذخیره کرده است. مدلهای بزرگ ابری وزنهای محاسباتی خود را با دقتهای شانزده بیتی و سیودو بیتی نگه میدارند تا عمیقترین مفاهیم ریاضی و استدلالهای چندلایهای را پوشش دهند. این در حالی است که یک مدل فشرده موبایلی با تکیه بر تکنیکهای زیر در ابعاد چند گیگابایت کارایی خیرهکنندهای ثبت میکند
- کوانتیزاسیون چهار بیتیتبدیل متغیرهای محاسباتی سنگین به قالبهای سبکتر تا مدل با کمترین استفاده از حافظه رم بهترین سرعت استنتاج را ارائه دهد.
- تقطیر سیستماتیک دانشروندی که در آن یک مدل بزرگ نقشه تصمیمگیری خود را به مدلی بسیار کوچکتر آموزش میدهد تا همان خروجی در قالب جمعوجور بازسازی شود.
- حذف اتصالات زائد یا هرس لایههاقطع کردن مسیرهای محاسباتی که در کارهای روزمره زبان انسانی تاثیر ملموسی بر کیفیت متن نمیگذارند.
- آموزش متمرکز با متون پالایششدهاستفاده از کتابهای درسی و متون استاندارد به جای دادههای نامنظم وب که خروجی را دقیق و باثبات نگه میدارد.
این رویکرد معماری موجب شده مدلهای کوچک از نظر حافظه فیزیکی بتوانند فضایی کمتر از دو گیگابایت را اشغال کنند؛ موضوعی که تا سالهای پیش روی موبایل غیرممکن شمرده میشد.
جدول مقایسه جامع شاخصهای فنی میان SLM و LLM
برای این که دید روشنی از جایگاه هر دو فناوری داشته باشیم، جدول زیر شاخصهای اساسی آنها را بر اساس سنجههای استاندارد پردازشی مقایسه میکند
| سنجه بررسی | مدل زبانی بزرگ (LLM) | مدل زبانی کوچک (SLM) |
| دامنه تعداد پارامترها | معمولا بین هفتاد تا فراتر از پانصد میلیارد پارامتر | معمولا بین یک تا نه میلیارد پارامتر فعال |
| زیرساخت میزبانی | کلاسترهای عظیم پردازشی و مزارع سرور ابری | تراشه محلی و واحد پردازش عصبی |
| وضعیت اتصال اینترنت | وابستگی کامل؛ بدون اینترنت قطع میشود | استقلال مطلق؛ عملکرد کاملا آفلاین در هر شرایط |
| تاخیر پاسخدهی | مشروط به پهنای باند و پینگ سرور راه دور | آنی و بلادرنگ با تولید کلمات بدون مکث شبکه |
| امنیت و حریم خصوصی | جریان داده روی اینترنت بهسمت سرور خارجی | توقف داده در دستگاه؛ بدون ردگیری بیرونی |
| میزان مصرف انرژی | هزاران کیلووات ساعت برق در دیتاسنتر | چند میلیآمپر از ظرفیت شارژ باتری گوشی |
| هزینه نگهداری زیرساخت | اشتراکهای ماهیانه سنگین و هزینه توسعه بالا | بدون هزینه پایدار سرور برای کاربر و سازنده |
| عمق استدلال مفهومی | بسیار بالا در علوم محض، فلسفه و کدهای چندلایه | ایدهآل در کارهای زبانی معین و روزمره |
سختافزار موبایل چگونه مدلهای زبانی را اجرا میکند؟
اجرای این حجم از پردازش ریاضی روی یک گجت جیبی مستلزم حضور بخشی اختصاصی در پردازندهها بود. تراشههای امروزی دیگر صرفا به هستههای گرافیکی و پردازنده مرکزی تکیه نمیکنند، بلکه هستههای محاسبات تانسوری یا همان واحدهای پردازش عصبی موسوم به NPU بار اصلی استنتاج را به دوش میکشند. این قطعات طوری طراحی شدهاند که ضرب ماتریسهای کوانتیزهشده را با کمترین توان مصرفی و حداقل تولید حرارت انجام دهند.
ساتیا نادلا مدیر مایکروسافت در سخنرانی توسعهدهندگان خود عنوان کرده بود که هوش مصنوعی واقعی زمانی خلق میشود که توان پردازش میان کوچکترین تراشههای جیبی و بزرگترین دیتاسنترهای جهانی به شکلی نامحسوس تقسیم شود. این تصویر به این معنی است که موبایل شما تبدیل به ایستگاه اول درک دستورات زبانی میشود و بدون معطلی به تحلیل ورودیها میپردازد.
هنگامی که شما یک فایل صوتی را در جلسه اداری ضبط میکنید، مدل محلی روی دستگاه وظیفه تفکیک صداها، تبدیل کلام به متن و استخراج فهرست اقدامات ضروری را بدون فرستادن ذرهای اطلاعات به اینترنت پیش میبرد. در تستهای مکرر آزمایشگاهی ثابت شده که انجام این فرایند درون گوشی نه تنها سرعت بالاتری دارد، بلکه ریسک افشای محتوای محرمانه کسبوکارها را به صفر میرساند.
چهار ویژگی حیاتی هوش مصنوعی لبه برای کاربران عادی
دلایل استقبال شرکتهای سازنده تلفنهای هوشمند از مدلهای زبانی کوچک تنها به جذابیت فنی محدود نمیشود، بلکه پای ارزشهای ملموس برای کاربر نهایی در میان است
- امنیت کامل دادههای شخصیوقتی عکسی ویرایش میشود، یادداشتی سامان میگیرد یا پیامی اصلاح میشود، محتوای آن فایل روی حافظه موقت محلی پردازش شده و به هیچ وجه در قالب بستههای دیتای وب به مقصدهای بیرونی منتقل نمیشود.
- دسترسی بیپایان در هر موقعیت مکانیداخل مترو، ارتفاعات کوهستانی یا شرایط پرواز که پوشش آنتندهی وجود ندارد، دستیار نوشتاری و مترجم زبان روی گوشی به فعالیت خود ادامه میدهد و کارهای روتین لنگ اینترنت نمیماند.
- واکنش بلادرنگ و روانحذف تاخیر پینگ سرور باعث میشود متن تولیدشده بلافاصله روی صفحه تایپ شود؛ حسی شبیه به اینکه یک نرمافزار ویرایشی پیشفرض و بسیار چابک در حال نوشتن به جای شماست.
- عمر بهتر باتری و پایداری عملکردمدلهای بهینهسازیشده برای تراشههای عصبی کممصرف نوشته شدهاند؛ بنابراین اجرای یک فرمان، باتری گوشی را خالی نمیکند و بدنه دستگاه بر خلاف زمان اجرای بازیهای سنگین، داغ نمیشود.
مدلهای مطرح دنیای فناوری در سال ۲۰۲۶
چندین نام بزرگ در عرصه مدلهای فشرده وجود دارد که پایههای پردازش محلی را شکل دادهاند. شناخت این نامها تصویر روشنی از نقشه پیشرفت این فناوری ترسیم میکند
- سری مدلهای فیخانواده مدلهای متمرکز بر کیفیت داده که شرکتهای نرمافزاری پیشرو در آنها نشان دادند با بهینهسازی محتوای آموزشی میتوان مدلی در ابعاد سه میلیارد پارامتر ساخت که در دقت زبان طبیعی، مدلهای ابری چند برابر بزرگتر را به چالش بکشد.
- جمینای نانوسیستمی که به شکل عمیق در لایههای هسته سیستمعامل اندروید ادغام شده و وظیفه پردازش ورودیهای برنامههای تماس، پیامها و کیبورد هوشمند را بدون ارتباط بیرونی پیادهسازی میکند.
- خانواده فشرده لامامدلهای متنبازی که به توسعهدهندگان مستقل اجازه میدهند برنامههای کاربردی اختصاصی خود را بسازند و بدون احتیاج به خرید زیرساختهای سروری گرانقیمت، هوش ماشینی را داخل اپلیکیشنهای موبایل تعبیه کنند.
- معماریهای محلی اپل اینتلیجنستمرکز بر یکپارچهسازی سختافزار اختصاصی سیلیکون با مدلهای زبانی مینیاتوری تا امور روزمره ایمیلها، دستهبندی اعلانها و ویرایش کلمات با پنهانکاری کامل انجام شود.
چه زمان مدلهای زبانی کوچک ناتوان میشوند؟
با وجود مزیتهای فراوان اجرای محلی، نادیده گرفتن جایگاه مدلهای بسیار بزرگ اشتباه است. واقعیت این است که توان ذخیرهسازی دانش در چند میلیارد پارامتر محدودیتهای فیزیکی دارد. اگر از یک سیستم کوچک مستقر در گوشی بخواهید یک تز دانشگاهی پانصد صفحهای را بخواند، میان اسناد متناقض تاریخی داوری کند یا کدنویسی یک پلتفرم نرمافزاری بزرگ چندلایه را انجام دهد، مدل دچار خطای آشکار میشود یا پاسخهایی سطحی تولید میکند.
مدلهای ابری صدها میلیارد پارامتری به دلیل پنجرههای زمینه عظیم که میتوانند میلیونها کلمه را به صورت همزمان تحلیل کنند، قدرت استدلال متفاوتی در حل معادلات پیچیده و مباحث عمیق فلسفی دارند. آنها نقش یک آزمایشگاه فکری با توان دسترسی به تمام منابع بشری را بازی میکنند؛ چیزی که فعلا در حافظه چند گیگابایتی یک گجت همراه قابل گنجاندن نیست.
سناریوی طلایی؛ همکاری مدل محلی با سرور ابری
بهترین الگوی پیادهسازی که امروزه در پیشرفتهترین گجتها مشاهده میشود، شیوه معماری دوگانه یا هیبریدی است. در این شیوه دستگاه هوشمند نقش دربان را بازی میکند. وقتی کاربر فرمانی صادر میکند، مدل کوچک مستقر روی گوشی ورودی را اسکن میکند. اگر درخواست مربوط به امور خصوصی، اصلاح متن، برنامهریزی تقویم، جستجو میان گالری یا کارهای روزمره باشد، پردازش بدون خروج از دستگاه به پایان میرسد.
اما اگر سوال به تحلیل دادههای بازار، ترجمه متون نادر کهن یا جستجوی اطلاعات زنده در اینترنت متصل باشد، سیستم با اجازه کاربر تقاضا را بستهبندی کرده و برای پردازش عمیق به سرور ابری انتقال میدهد. این تفکیک وظیفه موجب شده تا کاربران بدون فدا کردن امنیت یا سرعت، هر زمان که نیاز داشتند از قدرت محاسباتی سرورهای دوردست نیز بهرهمند گردند.
آینده هوش مصنوعی در دستان شما؛ مسیر پردازش لبه
مدلهای زبانی کوچک اثبات کردند که هوشمندی در ابعاد غولپیکر خلاصه نشده و کارایی واقعی از دل بهینهسازی دقیق سر برمیآورد. دیگر لازم نیست هر پرسش کوچک از میان کابلهای فیبر نوری اقیانوسها عبور کند تا پاسخی دریافت شود. آینده این عرصه در تسخیر مدلهای سریعی است که محرمانه، کممصرف و وفادار به سختافزار شخصی، دنیای پیرامون ما را در هر لحظه و هر مکان آسانتر میکنند.
سوالات متداول
این مدلها با حجم کم روی رم گوشی مینشینند و با کمک پردازنده عصبی کار استنتاج کلمات را کاملا آفلاین انجام میدهند.
مدل محلی بدون تاخیر شبکه فورا خروجی را تولید میکند اما مدل ابری همیشه وابسته به سرعت پینگ و شلوغی سرور است.
پردازندههای مدرن برای محاسبات ماتریسی بهینه شدهاند و فقط هنگام صدور فرمان فعال میشوند؛ پس مصرف باتری بسیار کم است.
برای خلاصهسازی و نگارش متن عالی هستند اما برای استدلالهای بسیار عمیق علمی مدلهای بزرگ ابری برتری محسوسی دارند.
به دلیل پردازش مستقیم در تراشه فیزیکی گوشی هیچ داده، صدا یا عکسی برای آنالیز به سرورهای خارجی ارسال نخواهد شد.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.