ذخیرهساز HPE Alletra X10000 - بررسی File و Object Storage | XNET
بررسی ذخیرهساز HPE Alletra MP X10000، ترکیب File و Object Storage، مشخصات فنی، مزایا، محدودیتها و کاربرد آن در دیتاسنترهای هوش مصنوعی.
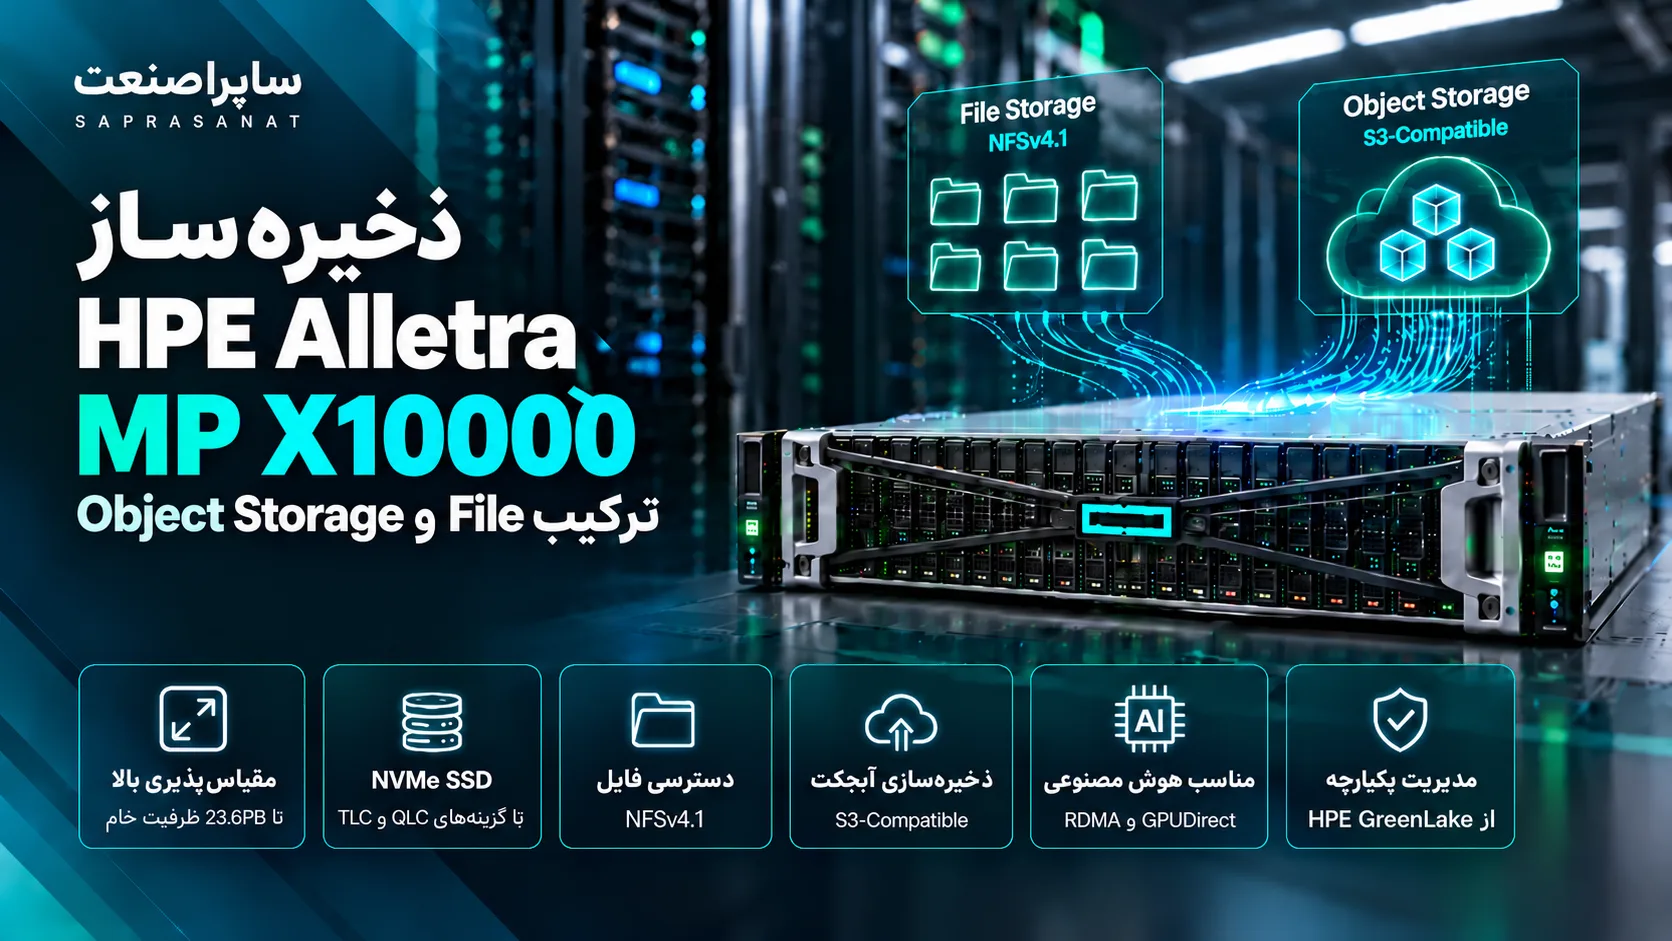
خلاصه تخصصی مقاله
بررسی ذخیرهساز HPE Alletra MP X10000، ترکیب File و Object Storage، مشخصات فنی، مزایا، محدودیتها و کاربرد آن در دیتاسنترهای هوش مصنوعی.
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، ظرفیت، X10000، داده، Storage
تصور کنید یک مجموعه تحقیقاتی چندین سرور مجهز به GPU دارد، اما هر بار که قرار است مدل هوش مصنوعی جدیدی آموزش ببیند، بخش قابل توجهی از زمان صرف پیدا کردن، کپی کردن و آمادهسازی دادهها میشود. مشکل لزوماً کمبود قدرت پردازشی نیست؛ گاهی اطلاعات میان چند سامانه ذخیرهسازی پراکنده شدهاند و دسترسی سریع به آنها دشوار است. ذخیرهساز HPE Alletra Storage MP X10000 برای پاسخ به بخشی از همین چالشها طراحی شده است.
برای سازمانهایی که قصدخرید ذخیرهساز HPیا توسعه زیرساخت ذخیرهسازی دیتاسنتر را دارند، X10000 یک محصول قابل بررسی در حوزه مدیریت دادههای غیرساختیافته است. این سیستم با ترکیب File Storage و Object Storage در یک پلتفرم، امکان استفاده از دادهها در سناریوهای مختلف را فراهم میکند. البته ارزش واقعی چنین معماری زمانی مشخص میشود که بدانیم هر نوع دسترسی چه کاربردی دارد، ظرفیت سیستم چگونه توسعه پیدا میکند و چه محدودیتهایی باید پیش از خرید بررسی شوند.
ذخیرهساز HPE Alletra Storage MP X10000 چیست؟
HPE Alletra Storage MP X10000 یک پلتفرم ذخیرهسازی سازمانی مقیاسپذیر است که برای مدیریت حجم بالایی از دادههای غیرساختیافته، پردازشهای تحلیلی، زیرساختهای هوش مصنوعی و حفاظت از اطلاعات طراحی شده است.
دادههای غیرساختیافته میتوانند شامل تصاویر، ویدئوها، فایلهای صوتی، اسناد، مجموعهدادههای آموزشی و خروجی برنامههای تحلیلی باشند. این اطلاعات معمولاً ساختار ثابتی مانند رکوردهای یک پایگاه داده رابطهای ندارند و با افزایش حجم آنها، مدیریت ظرفیت، دسترسی و جابهجایی داده دشوارتر میشود.
X10000 بر پایه معماری HPE Alletra Storage MP ساخته شده و از توسعه مستقل منابع پردازشی ذخیرهسازی و ظرفیت نگهداری اطلاعات پشتیبانی میکند. به این ترتیب، سازمان میتواند متناسب با نیاز خود منابع بیشتری به زیرساخت اضافه کند؛ بدون آنکه در هر مرحله الزاماً مجبور به افزایش همزمان تمام اجزای سیستم باشد.
• تفاوت X10000 با ذخیرهسازهای سنتی سازمانی
در بسیاری از زیرساختهای سنتی، یک سامانه برای فایلها، سامانهای دیگر برای Object Storage و تجهیزات جداگانهای برای حفاظت از دادهها استفاده میشود. چنین معماریای ممکن است در ابتدا پاسخگوی نیاز سازمان باشد، اما با افزایش حجم اطلاعات، نگهداری و هماهنگ کردن این محیطها دشوارتر میشود.
برای مثال، ممکن است دادههای خام ابتدا در یک مخزن Object ذخیره شوند، سپس برای پردازش به فضای فایل منتقل شوند و در نهایت خروجی دوباره به مخزن اولیه بازگردد. این فرایند همیشه ضروری نیست و در بعضی پروژهها هزینه و پیچیدگی اضافی ایجاد میکند.
X10000 با ارائه دسترسی File و Object روی یک پلتفرم مشترک، امکان طراحی جریان کاری سادهتری را فراهم میکند. البته این قابلیت به معنای حذف تمام نیازهای ذخیرهسازی سازمان نیست؛ برای کاربردهایی مانند پایگاه دادههای تراکنشی و دیسکهای اصلی ماشینهای مجازی، همچنان باید نوع مناسب Block Storage یا سایر راهکارها جداگانه بررسی شود.
• معماری Scale-Out در HPE Alletra X10000
در معماری Scale-Out، افزایش ظرفیت و توان سیستم از طریق اضافه کردن منابع جدید انجام میشود. این روش با ارتقای محدود یک کنترلر یا جایگزینی کامل یک ذخیرهساز تفاوت دارد.
در X10000، نودهای کنترلر و شلفهای ذخیرهسازی نقشهای مشخصی دارند. سازمان میتواند با توجه به نیاز پروژه، تعداد نودها یا ظرفیت ذخیرهسازی را در محدوده پیکربندیهای پشتیبانیشده افزایش دهد.
این ویژگی برای مجموعههایی کاربرد دارد که حجم دادههایشان بهصورت پیوسته رشد میکند. برای مثال، یک مرکز پردازش تصویر ممکن است در سال اول ظرفیت نسبتاً محدودی نیاز داشته باشد، اما با اضافه شدن دوربینها، پروژههای تحلیلی یا دادههای آموزشی، حجم اطلاعات آن چند برابر شود. در چنین شرایطی، قابلیت توسعه مرحلهای اهمیت زیادی دارد.
ترکیب File و Object Storage در HPE Alletra Storage MP X10000
یکی از تغییرات مهم X10000 در سال ۲۰۲۶، گسترش قابلیتهای ذخیرهسازی فایل در کنار Object Storage است. HPE در نسخههای جدید این پلتفرم، دسترسی بومی به فایل از طریق NFSv4.1 را در کنار رابط S3 ارائه کرده است.
این قابلیت برای سازمانهایی اهمیت دارد که بخشی از نرمافزارهایشان با ساختار فایل و پوشه کار میکنند، در حالی که سرویسهای دیگر از رابطهای Object Storage استفاده میکنند. بهجای نگهداری دو محیط کاملاً جداگانه، میتوان هر دو نوع دسترسی را در یک زیرساخت ذخیرهسازی طراحی کرد.
البته باید به تفاوت میان یکپارچه بودن پلتفرم و یکسان بودن تمام قابلیتهای پروتکلها توجه کرد. File Storage و Object Storage همچنان مدلهای دسترسی متفاوتی دارند و نحوه استفاده از آنها باید با نیاز نرمافزار هماهنگ باشد.
• File Storage و کاربرد NFSv4.1 در X10000
در File Storage، اطلاعات از طریق فایلها و دایرکتوریها مدیریت میشوند. این مدل برای نرمافزارهایی مناسب است که انتظار دارند با ساختار فایلسیستم کار کنند و عملیات خواندن، نوشتن و مدیریت فایل را از طریق رابطهای استاندارد انجام دهند.
X10000 از NFSv4.1 پشتیبانی میکند و قابلیت استفاده از این پروتکل روی TCP و RDMA نیز در مستندات HPE آمده است. فایلسیستم آن از رفتارهای سازگار با POSIX پشتیبانی میکند و برای کلاینتهای لینوکسی بهینهسازی شده است.
برای مثال، در یک محیط پردازش داده مبتنی بر Linux، برنامهها میتوانند به فضای فایل مشترک دسترسی داشته باشند. این موضوع در پروژههایی که ابزارهای پردازشی با فایلها و دایرکتوریها کار میکنند، اهمیت دارد.
بااینحال، پشتیبانی از NFS به معنای ارائه تمام قابلیتهای یک NAS عمومی نیست. برای نمونه، نباید بدون بررسی مستندات محصول، پشتیبانی بومی از SMB یا تمام رفتارهای قفلگذاری فایل را فرض کرد.
• Object Storage و نقش پروتکل S3
در Object Storage، اطلاعات بهصورت Object نگهداری میشوند و معمولاً از طریق API در اختیار نرمافزارها قرار میگیرند. هر Object علاوه بر داده اصلی میتواند اطلاعات توصیفی یا Metadata داشته باشد.
این مدل برای نگهداری مجموعههای بزرگ داده، آرشیوها، فایلهای رسانهای، نسخههای پشتیبان و دادههای مورد استفاده در پردازشهای تحلیلی کاربرد دارد. بسیاری از نرمافزارهای مدرن نیز برای ذخیره و بازیابی اطلاعات از API سازگار با S3 استفاده میکنند.
X10000 از دسترسی Object مبتنی بر S3 پشتیبانی میکند. البته سازگاری با S3 به معنای پشتیبانی از تمام قابلیتهای سرویس Amazon S3 نیست. برای مثال، بعضی عملیات مربوط به Bucket Policy، ACL در سطح Object یا تنظیمات خاص نگهداری داده ممکن است در نسخههای مشخص نرمافزار محدودیت داشته باشند.
پیش از انتقال یک برنامه موجود به X10000، بهتر است APIهای مورد استفاده نرمافزار با راهنمای سازگاری همان نسخه بررسی شوند.
مشخصات فنی ذخیرهساز HPE Alletra Storage MP X10000
در انتخاب ذخیرهساز سازمانی، تنها ظرفیت نهایی اهمیت ندارد. تعداد نودهای کنترلر، نوع SSDها، شبکه ارتباطی، روش توسعه و پروتکلهای قابل استفاده نیز باید بررسی شوند.
جدول زیر نمایی از مشخصات اصلی X10000 بر اساس مستندات HPE در اکتبر ۲۰۲۶ ارائه میکند. بعضی امکانات به نسخه نرمافزار، نوع پیکربندی و تجهیزات انتخابشده وابستهاند.
| ویژگی | مقدار یا توضیحات |
|---|---|
| مدل محصول | HPE Alletra Storage MP X10000 |
| نوع ذخیرهسازی | Unified File and Object Storage |
| معماری | Scale-Out / Disaggregated |
| پروتکل فایل | NFSv4.1 |
| پروتکل آبجکت | S3-Compatible API |
| حداکثر نود کنترلر | 16 نود |
| حداکثر شلف ذخیرهسازی | 16 شلف JBOF |
| فرمفاکتور شاسی | 2U |
| تعداد جایگاه درایو در شلف | 24 جایگاه NVMe SFF |
| نوع حافظه | NVMe SSD با گزینههای TLC و QLC |
| حداکثر ظرفیت خام | حدود 23.6PB در پیکربندی حداکثری |
| ارتباطات شبکه | گزینههای 10/25/100GbE و پیکربندیهای 400GbE |
| قابلیت توسعه | توسعه منابع کنترلر و ظرفیت ذخیرهسازی |
| مدیریت | HPE GreenLake / Data Services Cloud Console |
نکته فنیظرفیت خام، ظرفیت قابلاستفاده و ظرفیت مؤثر یکسان نیستند. مقدار واقعی فضای در دسترس به نوع حفاظت از داده، ظرفیت SSDها، تنظیمات سیستم و میزان فشردهسازی اطلاعات بستگی دارد.
• تعداد نودها و ظرفیت ذخیرهسازی
طبق QuickSpecs جدید HPE، پیکربندی X10000 میتواند تا ۱۶ نود کنترلر و ۱۶ شلف ذخیرهسازی توسعه پیدا کند. هر شلف دارای ۲۴ جایگاه برای SSDهای NVMe است؛ بنابراین، در پیکربندی حداکثری تا ۳۸۴ درایو قابل استفاده خواهد بود.
با استفاده از درایوهای پشتیبانیشده، ظرفیت خام سیستم میتواند به حدود ۲۳٫۶ پتابایت برسد. البته رسیدن به این عدد به انتخاب درایوها و رعایت قواعد پیکربندی بستگی دارد.
در این محصول، ترکیب آزادانه هر نوع SSD در یک شلف مجاز نیست. HPE برای نوع و ظرفیت درایوها قواعد مشخصی تعیین کرده است. برای مثال، درایوهای یک شلف باید از نوع و ظرفیت یکسان باشند و ترکیب TLC و QLC در یک کلاستر پشتیبانی نمیشود.
• استفاده از SSDهای TLC و QLC
X10000 از گزینههای NVMe SSD مبتنی بر TLC و QLC پشتیبانی میکند. این دو فناوری از نظر تراکم ذخیرهسازی، ویژگیهای نوشتن و تناسب با بارهای کاری متفاوتاند.
درایوهای TLC معمولاً برای محیطهایی که شدت نوشتن بیشتری دارند مناسبترند. در مقابل، QLC میتواند ظرفیت بالاتری را در هر درایو فراهم کند و برای کاربردهایی که اولویت اصلی نگهداری حجم زیاد داده است، گزینه قابل بررسی باشد.
برای مثال، یک مجموعه آرشیو ویدئویی ممکن است بیشتر اطلاعات را ذخیره کند و دفعات محدودی آنها را تغییر دهد. چنین محیطی با یک سامانه پردازش داده که دائماً فایلها را بازنویسی میکند، نیاز یکسانی ندارد.
انتخاب میان TLC و QLC باید بر اساس حجم نوشتن، طول عمر مورد انتظار، هزینه ظرفیت و توصیههای رسمی HPE انجام شود.
مزایای HPE Alletra X10000 برای دیتاسنترهای هوش مصنوعی
در پروژههای هوش مصنوعی، قدرت GPU تنها بخشی از زیرساخت موردنیاز است. دادهها باید جمعآوری، طبقهبندی، آمادهسازی و در زمان مناسب در اختیار منابع محاسباتی قرار بگیرند.
اگر دادهها در چند مخزن جداگانه پراکنده باشند، تیم فنی ممکن است زمان زیادی صرف انتقال اطلاعات و هماهنگ کردن دسترسیها کند. یک پلتفرم ذخیرهسازی یکپارچه میتواند بخشی از این پیچیدگی را کاهش دهد.
• دسترسی به دادههای آموزشی بدون ایجاد مخازن جداگانه
فرض کنید یک شرکت تولیدی برای شناسایی نقص محصولات از تصاویر خطوط تولید استفاده میکند. تصاویر خام در یک مخزن Object ذخیره میشوند، اما بعضی ابزارهای پردازش تصویر با فایلها و دایرکتوریها کار میکنند.
اگر این دو محیط کاملاً جدا باشند، ممکن است لازم شود دادهها مرتباً میان آنها کپی شوند. این کار هم فضای بیشتری مصرف میکند و هم مدیریت نسخههای مختلف داده را دشوارتر میسازد.
ترکیب File و Object در X10000 امکان طراحی جریان کاری منسجمتری را فراهم میکند. البته اینکه یک مجموعهداده دقیقاً چگونه از هر دو رابط قابل استفاده باشد، به ساختار Namespace، تنظیمات سیستم و رفتار نرمافزار بستگی دارد و باید در طراحی پروژه بررسی شود.
• ارتباط سریعتر با زیرساختهای GPU
در سیستمهای هوش مصنوعی، تأخیر در رساندن داده به GPU میتواند باعث کاهش بهرهوری منابع محاسباتی شود. به همین دلیل، علاوه بر ظرفیت ذخیرهسازی، مسیر انتقال داده نیز اهمیت زیادی دارد.
HPE برای X10000 قابلیتهای مرتبط با RDMA و NVIDIA GPUDirect Storage را توسعه داده است. این فناوریها در پیکربندیهای پشتیبانیشده میتوانند به کاهش سربار انتقال داده و بهبود مسیر دسترسی برنامههای شتابگرفته کمک کنند.
X10000 در مارس ۲۰۲۶ موفق به دریافت اعتبارسنجی NVIDIA-Certified Storage برای Object Storage در سطح Foundation شد. این اعتبارسنجی، توانایی پلتفرم را در چارچوب آزمونهای مشخص مربوط به زیرساختهای هوش مصنوعی نشان میدهد.
البته دریافت این گواهی به معنای تضمین عملکرد یکسان در تمام پروژهها نیست. سرعت واقعی به شبکه، سرورهای محاسباتی، نرمافزار و پیکربندی ذخیرهسازی بستگی دارد.
• مدیریت دادههای موردنیاز برای AI و Analytics
بخش مهمی از هزینه پروژههای هوش مصنوعی به آمادهسازی داده مربوط میشود. فایلها ممکن است تکراری باشند، Metadata کافی نداشته باشند یا در مکانهای مختلف نگهداری شوند.
HPE قابلیتهای Data Intelligence را برای کمک به شناسایی، غنیسازی و آمادهسازی دادههای غیرساختیافته توسعه داده است. هدف این امکانات آن است که اطلاعات موجود در زیرساخت ذخیرهسازی برای کاربردهای تحلیلی و هوش مصنوعی قابل استفادهتر شوند.
البته این قابلیتها جایگزین کامل فرایندهای Data Engineering نیستند. کیفیت داده، کنترل دسترسی، طبقهبندی اطلاعات و طراحی جریان پردازش همچنان به برنامهریزی و نظارت تیم فنی نیاز دارند.
کاربردهای HPE Alletra Storage MP X10000 در سازمانها
کاربرد X10000 محدود به آموزش مدلهای هوش مصنوعی نیست. هر محیطی که با حجم زیادی از دادههای غیرساختیافته سروکار دارد، ممکن است از معماری این محصول بهره ببرد.
بااینحال، نوع بار کاری باید پیش از انتخاب بررسی شود. بعضی سازمانها بیشتر به ظرفیت ذخیرهسازی نیاز دارند، بعضی به توان عملیاتی بالا و گروهی نیز به ترکیبی از عملکرد، حفاظت از داده و قابلیت توسعه.
• ذخیرهسازی دادههای تصویری و ویدئویی
مراکز رسانهای، مجموعههای تحقیقاتی و سازمانهایی که دادههای تصویری حجیم تولید میکنند، معمولاً با رشد سریع ظرفیت مواجهاند.
برای نمونه، در یک سامانه تحلیل ویدئو ممکن است فایلهای خام برای مدت طولانی نگهداری شوند، در حالی که بخشی از همان اطلاعات برای پردازش هوش مصنوعی استفاده میشود.
X10000 میتواند برای چنین سناریوهایی بررسی شود؛ زیرا امکان نگهداری حجم زیاد داده و ارائه دسترسی File و Object را در یک پلتفرم فراهم میکند.
• زیرساختهای Backup و حفاظت از داده
یکی دیگر از حوزههای کاربرد X10000، حفاظت از اطلاعات سازمانی است. HPE برای این محصول امکاناتی مانند Data Protection Accelerator Node را ارائه میکند که با هدف افزایش توان پردازش عملیات حفاظت از داده طراحی شده است.
این قابلیت برای محیطهایی اهمیت دارد که باید حجم بالایی از اطلاعات را در پنجره زمانی محدودی پشتیبانگیری کنند.
البته سازگاری با نرمافزار Backup، روش بازیابی، سیاست نگهداری نسخهها و ظرفیت مؤثر باید جداگانه بررسی شوند. داشتن توان بالای دریافت داده بهتنهایی تضمین نمیکند که تمام سناریوهای بازیابی سازمان با همان سرعت انجام شوند.
• Data Lake و تحلیل اطلاعات سازمانی
در معماری Data Lake، اطلاعات از منابع مختلف جمعآوری میشوند تا برای تحلیل و پردازشهای بعدی در دسترس باشند. این دادهها میتوانند شامل فایلهای ساختیافته، نیمهساختیافته و غیرساختیافته باشند.
Object Storage یکی از گزینههای رایج برای نگهداری چنین مجموعههایی است. وجود دسترسی فایل در کنار Object نیز میتواند برای بعضی ابزارهای پردازشی و جریانهای کاری مفید باشد.
X10000 برای پروژههایی مناسبتر است که به ظرفیت بالا، توسعهپذیری و دسترسی سریع به دادههای حجیم نیاز دارند. با وجود این، طراحی Data Lake همچنان به انتخاب ابزارهای پردازش، مدیریت Metadata و سیاستهای امنیتی مناسب وابسته است.
محدودیتها و نکات مهم HPE Alletra Storage MP X10000
هیچ ذخیرهسازی برای تمام کاربردها بهترین انتخاب نیست. X10000 نیز با وجود قابلیتهای پیشرفته، برای گروه مشخصی از بارهای کاری طراحی شده و باید با نیاز سازمان تطبیق داده شود.
برای مثال، شرکتی که فقط به فضای ذخیرهسازی محدود برای چند فایلسرور نیاز دارد، ممکن است از بخش بزرگی از ظرفیت و امکانات این پلتفرم استفاده نکند. در مقابل، یک مجموعه بزرگ تحلیل داده میتواند نیاز کاملاً متفاوتی داشته باشد.
• محدودیتهای پروتکل و سازگاری نرمافزاری
پشتیبانی از S3-Compatible API به معنای پیادهسازی تمام امکانات Amazon S3 نیست. بعضی عملیات مربوط به Bucket Policy، Object ACL و تنظیمات پیشرفته نگهداری داده در مستندات نسخههای مشخص X10000 محدودیت دارند.
در بخش فایل نیز NFSv4.1 پروتکل اصلی اعلامشده است. بنابراین، اگر نرمافزار سازمان به SMB یا رفتارهای خاص یک فایلسیستم نیاز دارد، نباید سازگاری آن را بدون بررسی فرض کرد.
بهترین روش این است که پیش از خرید، فهرست APIها، امکانات فایلسیستم و محدودیتهای نسخه نرمافزار با نیاز برنامهها تطبیق داده شوند. اجرای آزمایشی بار کاری نیز میتواند مشکلات احتمالی را زودتر مشخص کند.
• هزینه و پیچیدگی زیرساخت
X10000 یک پلتفرم سازمانی Scale-Out است و پیادهسازی آن فقط به خرید چند SSD محدود نمیشود. نودهای کنترلر، شلفهای ذخیرهسازی، تجهیزات شبکه، اشتراکهای نرمافزاری و خدمات پشتیبانی نیز در طراحی نهایی نقش دارند.
برای سازمانی که به ظرفیت محدود و بار کاری ساده نیاز دارد، چنین زیرساختی ممکن است از نظر اقتصادی توجیه نداشته باشد.
در مقابل، مجموعهای که حجم دادههای آن بهسرعت افزایش پیدا میکند، ممکن است از قابلیت توسعه مرحلهای و کاهش پراکندگی سامانههای ذخیرهسازی بهره ببرد. محاسبه هزینه مالکیت باید علاوه بر قیمت اولیه، مصرف انرژی، فضای رک، مدیریت و پشتیبانی را نیز شامل شود.
• وابستگی عملکرد به شبکه و پیکربندی
افزایش تعداد نودها یا استفاده از SSDهای سریع بهتنهایی عملکرد مطلوب را تضمین نمیکند. مسیرهای ارتباطی بین نودها، شبکه دسترسی کلاینتها و نوع بار کاری میتوانند بر نتیجه تأثیر بگذارند.
برای مثال، اگر چند سرور پردازشی از طریق شبکهای با ظرفیت ناکافی به ذخیرهساز متصل شوند، توان بالای سیستم ذخیرهسازی بهطور کامل در اختیار برنامهها قرار نمیگیرد.
به همین دلیل، طراحی X10000 باید همراه با بررسی شبکه دیتاسنتر، تعداد کلاینتها، الگوی درخواستها و میزان رشد اطلاعات انجام شود.
تفاوت HPE Alletra Storage MP X10000 با B10000
با وجود شباهت نام و استفاده از معماری Alletra Storage MP، مدلهای X10000 و B10000 برای اولویتهای یکسانی طراحی نشدهاند.
HPE Alletra Storage MP B10000 بیشتر بر ذخیرهسازی Block برای بارهای کاری حیاتی سازمانی تمرکز دارد و قابلیتهای فایل نیز در سبد راهکارهای مرتبط با آن ارائه میشوند. در مقابل، X10000 برای دادههای غیرساختیافته، Object Storage، دسترسی فایل و کاربردهای AI و Analytics جایگاه مشخصتری دارد.
اگر سازمان به ذخیرهسازی اصلی ماشینهای مجازی، پایگاههای داده تراکنشی یا کاربردهای حساس Block نیاز داشته باشد، بررسی B10000 منطقیتر است. اما برای مجموعهدادههای حجیم، مخازن Object و جریانهای پردازشی مبتنی بر فایل، X10000 میتواند گزینه مناسبتری باشد.
انتخاب میان این دو محصول نباید فقط بر اساس ظرفیت یا جدیدتر بودن مدل انجام شود. پروتکل موردنیاز، نوع برنامه، الزامات دسترسپذیری و هزینه کل زیرساخت معیارهای مهمتری هستند.
نکات مهم هنگام خرید ذخیرهساز HPE Alletra X10000
پیش از انتخاب X10000 باید تصویری روشن از وضعیت فعلی دادههای سازمان وجود داشته باشد. حجم اطلاعات، نرخ رشد سالانه، نوع دسترسی نرمافزارها و نیازهای حفاظت از داده از نخستین مواردی هستند که باید مشخص شوند.
در مرحله بعد، طراحی پیکربندی سختافزاری اهمیت پیدا میکند. تعداد نودها و شلفها، نوع SSDها و ظرفیت شبکه باید با نیاز فعلی و برنامه توسعه آینده هماهنگ باشند.
مهمترین مواردی که پیش از خرید باید بررسی شوند عبارتاند از
- نوع بار کاریمشخص شود سیستم برای AI، Analytics، Object Storage، فایل یا حفاظت از داده استفاده خواهد شد.
- ظرفیت خام و قابلاستفادهفضای واقعی موردنیاز با در نظر گرفتن روش حفاظت از داده محاسبه شود.
- نوع SSDانتخاب TLC یا QLC بر اساس شدت نوشتن و نیاز ظرفیت انجام شود.
- تعداد نودها و شلفهاپیکربندی اولیه و مسیر توسعه آینده مشخص باشد.
- پروتکلهای موردنیازسازگاری NFSv4.1 و S3 با نرمافزارهای سازمان بررسی شود.
- شبکه دیتاسنترپهنای باند و تجهیزات ارتباطی با توان ذخیرهساز هماهنگ باشند.
- حفاظت و بازیابی اطلاعاتسیاست Backup، Replication و بازیابی متناسب با الزامات سازمان طراحی شود.
- نسخه نرمافزار و اشتراکهاقابلیتهای موردنیاز در نسخه انتخابشده و قرارداد پشتیبانی موجود باشند.
یکی از اشتباهات رایج در انتخاب ذخیرهساز، تمرکز بیش از حد روی ظرفیت اسمی است. ممکن است دو پیکربندی ظرفیت خام مشابهی داشته باشند، اما از نظر عملکرد، فضای قابلاستفاده یا امکان توسعه تفاوت زیادی میان آنها وجود داشته باشد.
خدمات مشاوره و تأمین ذخیرهساز HPE در XNET
انتخاب ذخیرهساز سازمانی، بهویژه برای پروژههای هوش مصنوعی و مدیریت دادههای حجیم، به بررسی دقیق نیازهای فنی وابسته است. صرف مشاهده مشخصات یک محصول نمیتواند نشان دهد که همان پیکربندی برای محیط عملیاتی سازمان مناسب خواهد بود.
در XNET، مشاوره انتخاب تجهیزات HPE با توجه به نیاز ظرفیت، نوع بار کاری، سازگاری تجهیزات و برنامه توسعه زیرساخت انجام میشود. برای محصولاتی مانند X10000، بررسی معماری شبکه، نوع دسترسی به داده و امکانات نرمافزاری اهمیت ویژهای دارد.
XNET در زمینه تأمین تجهیزات ذخیرهسازی وسرور اچ پیمشاوره فنی، نصب، راهاندازی و خدمات پشتیبانی فعالیت میکند. مشاوره رایگان پیش از خرید، ضمانت اصالت کالا، گارانتی یکساله سختافزار و سه سال خدمات پس از فروش نیز از مزایای خدمات این مجموعه است.
پیش از ثبت سفارش چنین تجهیزاتی، لازم است مدل دقیق، شماره فنی، پیکربندی قابل تأمین و شرایط پشتیبانی بررسی شود. به این ترتیب، سازمان میتواند بهجای انتخاب صرفاً بر اساس حداکثر مشخصات اعلامشده، زیرساختی متناسب با نیاز واقعی خود تهیه کند.
آینده ذخیرهسازی یکپارچه File و Object در دیتاسنترها
افزایش حجم دادههای غیرساختیافته و گسترش کاربردهای هوش مصنوعی باعث شده معماری ذخیرهسازی نقش مهمتری در طراحی دیتاسنتر پیدا کند. در گذشته، ذخیرهسازی بیشتر محلی برای نگهداری اطلاعات بود؛ اما در پروژههای جدید، سرعت آمادهسازی و دسترسی به داده نیز بر بهرهوری منابع محاسباتی اثر میگذارد.
ترکیب File و Object در یک پلتفرم میتواند بخشی از پیچیدگی مدیریت داده را کاهش دهد. این رویکرد بهخصوص برای سازمانهایی اهمیت دارد که همزمان از نرمافزارهای مبتنی بر فایل و سرویسهای سازگار با S3 استفاده میکنند.
البته یکپارچهسازی به معنای حذف تمام سامانههای تخصصی نیست. همچنان برای بعضی بارهای کاری، ذخیرهسازی Block، سامانههای آرشیوی یا راهکارهای Backup مستقل انتخاب مناسبتری خواهند بود.
آینده این حوزه احتمالاً به سمت مدیریت هوشمندتر داده، ارتباط نزدیکتر با زیرساختهای GPU و توسعه ظرفیت بدون اختلال گسترده در سرویسها حرکت میکند. X10000 یکی از نمونههای این تغییر در سبد ذخیرهسازی HPE است.
جمعبندی
HPE Alletra Storage MP X10000 با ترکیب Object Storage و دسترسی فایل مبتنی بر NFSv4.1، امکان طراحی زیرساختی یکپارچهتر برای دادههای غیرساختیافته فراهم میکند. معماری Scale-Out، استفاده از SSDهای NVMe و قابلیت توسعه تا حدود ۲۳٫۶ پتابایت ظرفیت خام، این محصول را برای پروژههای بزرگ ذخیرهسازی و پردازش داده قابل توجه کرده است.
مزیت اصلی X10000 فقط ظرفیت بالای آن نیست. امکان ارائه File و Object روی یک پلتفرم، قابلیتهای مرتبط با RDMA و GPUDirect Storage و امکانات حفاظت و مدیریت داده میتوانند در طراحی زیرساختهای هوش مصنوعی نقش داشته باشند.
با وجود این، انتخاب چنین ذخیرهسازی باید بر اساس نوع بار کاری، نیازهای نرمافزاری، ظرفیت شبکه و هزینه کل مالکیت انجام شود. برای بعضی سازمانها، X10000 میتواند بخشی از پراکندگی سامانههای ذخیرهسازی را کاهش دهد؛ برای بعضی دیگر، راهکاری کوچکتر یا تخصصیتر ممکن است انتخاب اقتصادی مناسبتری باشد.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.