مدیریت رخداد امنیتی از مرکز عملیات امنیت (SOC) تا مدیریت خدمات فناوری اطلاعات (ITSM)
چه زمانی رخداد امنیتی به اختلال سرویس تبدیل میشود؟ راهنمای کاربردی هماهنگی SOC و ITSM، تفکیک شدت تهدید از اولویت بازیابی و مهار بدون قطعی کسبوکار.
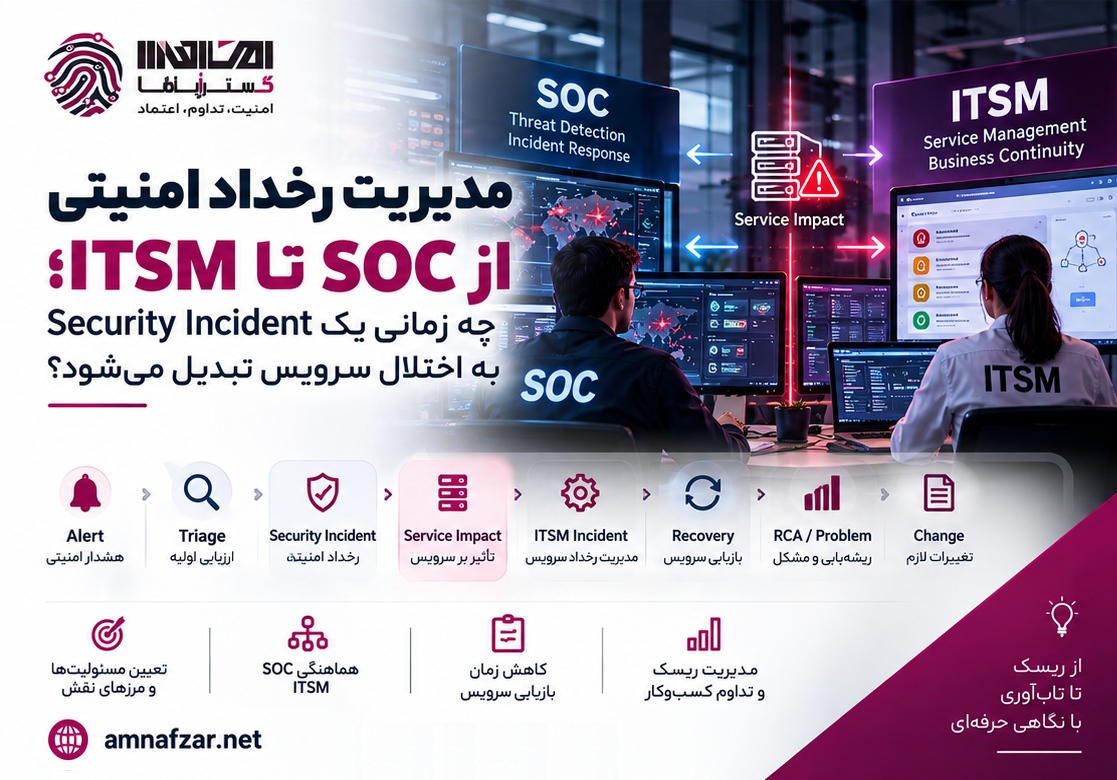
خلاصه تخصصی مقاله
چه زمانی رخداد امنیتی به اختلال سرویس تبدیل میشود؟ راهنمای کاربردی هماهنگی SOC و ITSM، تفکیک شدت تهدید از اولویت بازیابی و مهار بدون قطعی کسبوکار.
موضوعات اصلی: پشتیبانی شبکه، امنیت سایبری، سرویس، امنیتی، مدیریت، امنیت
با گسترش وابستگی سازمانها به خدمات دیجیتال، تهدیدات امنیت سایبری دیگر تنها یک مسئله فنی یا محدود به حفاظت از اطلاعات نیستند؛ بلکه میتوانند مستقیماً بر پایداری خدمات، تداوم فعالیتهای کسبوکار و اعتماد مشتریان تأثیر بگذارند. در چنین شرایطی، شناسایی و مهار تهدید بهتنهایی کافی نیست؛ سازمان باید بتواند اثر هر رخداد امنیتی را بر خدمات خود تشخیص دهد و برای جلوگیری از اختلال یا بازیابی سریع خدمات تصمیم بگیرد. این موضوع اهمیت هماهنگی میان مرکز عملیات امنیت (SOC) و مدیریت خدمات فناوری اطلاعات (ITSM) را آشکار میکند. اما پرسش اصلی این است که چه زمانی یک رخداد امنیتی به مسئلهای در مدیریت خدمات تبدیل میشود و چگونه میتوان میان الزامات امنیتی و حفظ پایداری خدمات تعادل برقرار کرد؟
چه زمانی یک رخداد امنیتی به اختلال سرویس تبدیل میشود؟
فرض کنید مرکز عملیات امنیت (SOC) دسترسی مشکوک به یک حساب مدیریتی را شناسایی کرده است. هنوز هیچ سرویسی قطع نشده، اما برای مهار تهدید باید حساب مسدود شود. مسئله اینجاست که همان حساب، بخشی از پردازش خودکار سفارشها را اجرا میکند. مسدودسازی فوری ممکن است حمله را متوقف کند، ولی همزمان سرویس کسبوکار را از کار بیندازد. در این نقطه، رخداد امنیتی دیگر فقط موضوع تیم امنیت نیست؛ تصمیم امنیتی پیامد عملیاتی دارد و باید با مدیریت خدمات فناوری اطلاعات (ITSM) هماهنگ شود.
مرز رخداد امنیتی و اختلال سرویس کجاست؟
رخداد امنیتی زمانی مطرح میشود که شواهد، نقض یا تهدید جدی امنیت اطلاعات را نشان دهند. اختلال سرویس زمانی رخ میدهد که دسترسپذیری، کیفیت، صحت عملکرد یا توان ارائه خدمت به کاربران کاهش یابد. بنابراین هر هشدار امنیتی، اختلال سرویس نیست و هر رخداد امنیتی نیز الزاماً به قطعی منجر نمیشود.
معیار اصلی برای ورود تیم مدیریت خدمات (ITSM)، اثر مشاهدهشده یا محتمل بر کسبوکار است؛ نه صرفاً درجه خطر هشدار. اختلال ممکن است به شکل افزایش خطای تراکنش، کندی شدید، ناتوانی کاربران در ورود، داده نادرست یا محدودیت عمدی ناشی از اقدام دفاعی ظاهر شود. حتی اگر سرویس ظاهراً روشن باشد، ممکن است کارکرد حیاتی آن از دست رفته باشد.
نقشها را جدا کنید، تصمیمها را هماهنگ بگیرید
مرکز عملیات امنیت (SOC) مسئول بررسی شواهد، تشخیص دامنه تهدید، ارزیابی احتمال نفوذ و پیشنهاد مهار است. خروجی آن باید فراتر از یک هشدار خام باشد: دارایی درگیر، شواهد تأییدشده، موارد نامشخص، فوریت مهار و پیامد احتمالی اقدام دفاعی باید روشن باشد.
مدیریت خدمات فناوری اطلاعات (ITSM)، اثر رخداد بر سرویس را ثبت و مدیریت میکند: کدام خدمت آسیب دیده، چه فرایند کسبوکاری متوقف شده، مالک خدمت چه کسی است و بازیابی با چه اولویتی انجام میشود. مدیریت رخداد خدمت، مدیریت مشکل، مدیریت تغییر و ارتباط با ذینفعان باید در یک مسیر هماهنگ قرار گیرند.
بهتر است برای رخدادهای مهم، پرونده امنیتی و پرونده اختلال سرویس مستقل اما بههممرتبط باشند. پرونده امنیتی برای تحلیل تهدید و حفظ شواهد است؛ پرونده سرویس برای مدیریت اثر، بازیابی و اطلاعرسانی. هر دو پرونده باید شناسه مشترک یا پیوند قابل ردیابی داشته باشند.
شدت تهدید با اولویت بازیابی یکسان نیست
شدت امنیتی براساس اعتبار شواهد، سطح دسترسی مهاجم، گستره نفوذ و حساسیت داده تعیین میشود. اولویت سرویس به تعداد کاربران متأثر، اهمیت فرایند کسبوکار، مدت اختلال و امکان استفاده از راهکار جایگزین بستگی دارد. برای نمونه، نفوذ به یک حساب ممتاز ممکن است از نظر امنیتی بحرانی باشد، در حالی که هنوز اختلال عملیاتی ایجاد نکرده است. برعکس، مسدودشدن سرویس احراز هویت مشترک میتواند چند خدمت حیاتی را همزمان مختل کند.
یکپارچهسازی این دو ارزیابی به معنای تبدیل آنها به یک امتیاز نیست؛ سازمان باید برای هر کدام معیار، مالک تصمیم و آستانه ارجاع مشخص داشته باشد.
الگوی عملیاتی از کشف تهدید تا بازیابی
۱. اعتبارسنجی هشدار: تیم امنیت شواهد را بررسی و تفاوت میان احتمال حمله و نفوذ تأییدشده را ثبت میکند.
۲. شناسایی وابستگیها: دارایی آلوده یا مشکوک به سرویسهای مرتبط و مالکان آنها متصل میشود. پایگاه داده مدیریت پیکربندی (CMDB) در صورت بهروز بودن، این مرحله را سرعت میدهد.
۳. ارزیابی اثر: تیم سرویس مشخص میکند چه کاربران، تراکنشها یا قابلیتهایی آسیب دیدهاند و اقدام مهار چه اختلال تازهای ایجاد میکند.
۴. تصمیم مشترک: مسئول امنیت، مالک سرویس و تیم فنی درباره روش مهار، سطح اختیار اضطراری، اطلاعرسانی و برنامه بازگشت توافق میکنند.
۵. مهار و بازیابی کنترلشده: تهدید محدود میشود، اما بازگشت سرویس تنها پس از بررسی دسترسپذیری، صحت داده و نبود نشانههای تداوم نفوذ تأیید میشود.
۶. تحلیل پس از رخداد: علتهای فنی، تأخیر در هماهنگی، تغییرات لازم و اقدامات پیشگیرانه ثبت و پیگیری میشوند.
مثال عملی: وقتی اقدام امنیتی خود عامل اختلال میشود
فرض کنید یک حساب دارای دسترسی بالا در سامانه سفارشگیری رفتار غیرعادی دارد. تیم امنیت پیشنهاد غیرفعالسازی فوری حساب را میدهد. بررسی وابستگیها نشان میدهد حساب یادشده برای اجرای یک کار خودکار ضروری است. در مدل ناهماهنگ، حساب مسدود میشود و پردازش سفارشها متوقف میماند. در مدل هماهنگ، تیم امنیت خطر را اعلام میکند؛ مالک سرویس وابستگی را تأیید میکند؛ تیم فنی راهکار امن جایگزین را آماده میسازد و مدیریت خدمات، اختلال و اولویت بازیابی را پیگیری میکند.
هدف، تأخیر بیدلیل در مهار نیست؛ هدف، مهار سریع همراه با آگاهی از پیامد و برنامه بازیابی است.
چه اطلاعاتی باید بین دو تیم جریان داشته باشد؟
حداقل داده مشترک شامل شناسه پروندهها، زمان کشف و تأیید، دارایی و سرویس مرتبط، مالک اقدام، شواهد تأییدشده، اثر واقعی یا احتمالی بر کاربران، اقدام مهار، زمان تصمیم بعدی و وضعیت بازیابی است. جزئیات حساس حمله باید فقط در اختیار نقشهای مجاز قرار گیرد؛ تیم عملیاتی برای تصمیمگیری به اثر و اقدام مورد نیاز احتیاج دارد، نه لزوماً تمام شواهد محرمانه.
برای سنجش اثربخشی اتصال، چهار شاخص کافی است: زمان تشخیص سرویس متأثر پس از هشدار معتبر؛ زمان اطلاعرسانی به مالک خدمت؛ تعداد اختلالهای ناخواسته ناشی از مهار؛ و درصد بازیابیهایی که با آزمون عملکرد و صحت داده تأیید شدهاند. این شاخصها باید به تصمیم اصلاحی منجر شوند، نه صرفاً تکمیل داشبورد.
خطاهایی که هماهنگی را از بین میبرند
ارسال هشدار خام بدون مشخصکردن خدمت متأثر، یکسانگرفتن شدت امنیتی و اولویت سرویس، قرنطینه بدون بررسی وابستگیها، نامشخصبودن مالک تصمیم اضطراری و بستن پرونده بهمحض سبزشدن پایش، از خطاهای پرتکرار هستند. راهحل عملی، تعریف معیار ارجاع، ماتریس مسئولیت، ارتباط بین پروندهها و اجرای تمرین مشترک است.
امنیت و تداوم خدمت، دو مسیر جدا نیستند
رخداد امنیتی زمانی به اختلال سرویس تبدیل میشود که عملکرد خدمت یا تجربه کاربران را تحت تأثیر قرار دهد؛ اما هماهنگی نباید تا لحظه قطعی کامل به تأخیر بیفتد. سازمانی که وابستگی داراییها به خدمات حیاتی را میشناسد، شدت تهدید را از اولویت بازیابی جدا میکند و برای مهار پراثر تصمیم مشترک میگیرد، هم سریعتر تهدید را محدود میکند و هم با اطمینان بیشتری سرویس را بازمیگرداند.
XNETدر ارزیابی ارتباط میان عملیات امنیت و مدیریت خدمات، شناسایی شکافهای هماهنگی و طراحی سناریوهای آزمون و بهبود فرایندها همراه سازمانهاست و باسامانه مدیریت امنیت اطلاعات ایزوافزارساختار سیستماتیک یکپارچه را نیز برای سازمان شما فراهم میآورد.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.