آن حروف ناخوانای اعصابخردکن بیدلیل نبودند؛ ماجرای عجیب کپچاهای قدیمی اینترنت
سیستم ریکپچا سالها با مقایسه پاسخ کاربران، کلمات ناخوانای اسناد فرسوده را شناسایی میکرد و بیش از ۴۴۰ میلیون واژه تاریخی را نجات داد. سالها پیش، وقتی کاربران اینترنت برای اثبات اینکه ربات نیستند کلمات ناخوانای روی صفحه را تایپ میکردند، ناخواسته در پروژهای…
خلاصه تحلیلی خبر
سیستم ریکپچا سالها با مقایسه پاسخ کاربران، کلمات ناخوانای اسناد فرسوده را شناسایی میکرد و بیش از ۴۴۰ میلیون واژه تاریخی را نجات داد. سالها پیش، وقتی کاربران اینترنت برای اثبات اینکه ربات نیستند کلمات ناخوانای روی صفحه را تایپ میکردند، ناخواسته در پروژهای…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، کلمات، کاربر، reCAPTCHA، کتابها
سیستم ریکپچا سالها با مقایسه پاسخ کاربران، کلمات ناخوانای اسناد فرسوده را شناسایی میکرد و بیش از ۴۴۰ میلیون واژه تاریخی را نجات داد.
سالها پیش، وقتی کاربران اینترنت برای اثبات اینکه ربات نیستند کلمات ناخوانای روی صفحه را تایپ میکردند، ناخواسته در پروژهای بزرگ برای دیجیتالیکردن کتابها و روزنامههای قدیمی مشارکت داشتند. این ایده پشت سرویس reCAPTCHA بود که گوگل در سال ۲۰۰۹ آن را خرید.
اگر از کاربران قدیمی اینترنت باشید، احتمالاً تصویرهایی با حروف کجومعوج و کلمات محوشده را به یاد دارید که برای ورود به سایتها یا ثبتنام در سرویسهای آنلاین باید آنها را میخواندید و تایپ میکردید. این آزمونها که کپچا (CAPTCHA) نام دارند، برای تشخیص انسان از ربات طراحی شده بودند.
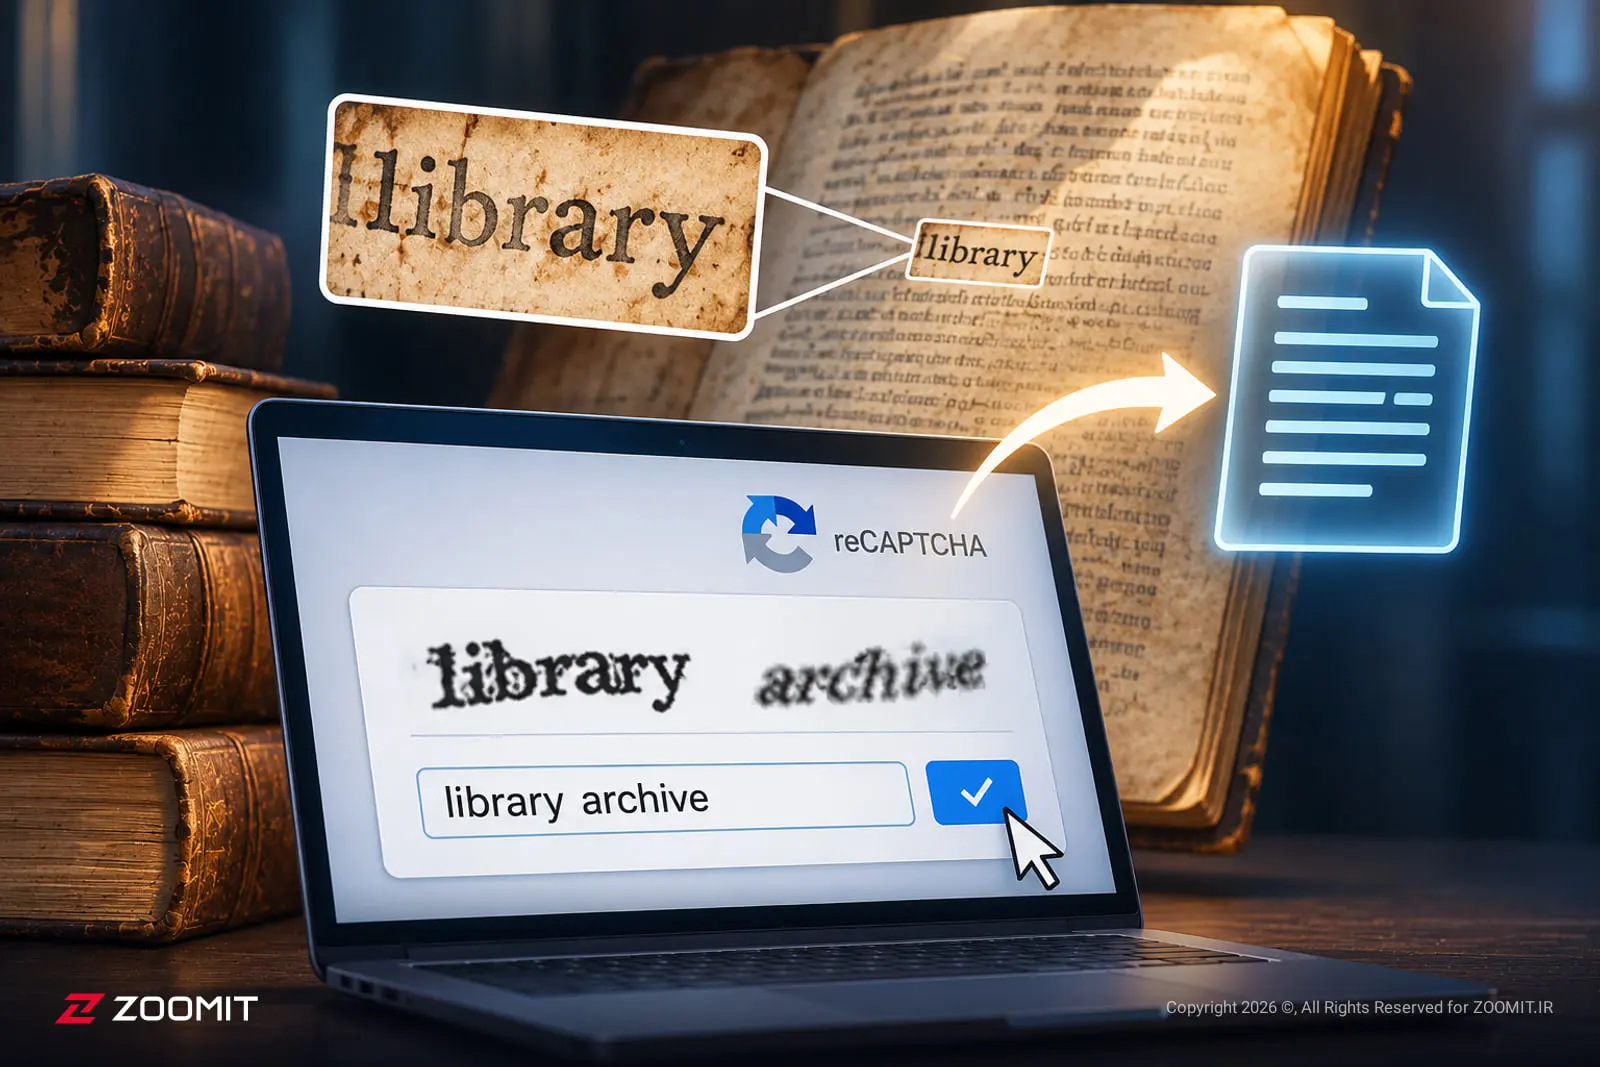
اما نسخهای از این فناوری به نام reCAPTCHA کاربرد جالب دیگری هم داشت: کمک به خواندن متن کتابها و روزنامههایی که کامپیوتر از تشخیص کلمات آنها ناتوان بود.
هنگام اسکن کتابهای قدیمی، نرمافزارهای تشخیص متن یا OCR تلاش میکنند نوشتههای داخل تصاویر را به متن قابلجستوجو تبدیل کنند؛ اما کاغذهای فرسوده، لکههای جوهر و حروف محوشده باعث میشوند بعضی کلمات بهدرستی تشخیص داده نشوند.
کاری که برای هر کاربر فقط چند ثانیه طول میکشید، در مقیاس میلیونی به فرایندی گسترده برای بازخوانی اسناد تاریخی تبدیل شد
اینجا بود که ایدهی reCAPTCHA به کار میآمد. کاربران معمولاً دو کلمه میدیدند: یکی با پاسخ از پیش مشخص برای تأیید انسانبودن کاربر و دیگری کلمهای از یک سند اسکنشده که نرمافزار نتوانسته بود آن را بخواند.
کاربر با تایپ این دو کلمه، هم ثابت میکرد انسان است و هم به خواندن یک کلمهی ناخوانا از کتابی قدیمی کمک میکرد.
برای جلوگیری از ثبت پاسخ اشتباه، سیستم پاسخ چندین کاربر را با یکدیگر مقایسه میکرد. وقتی افراد مختلف به نتیجهی مشابهی میرسیدند، سامانه میتوانست با اطمینان بیشتری متن صحیح را شناسایی کند.
به این ترتیب، کاری که برای هر کاربر فقط چند ثانیه طول میکشید، در مقیاس میلیونها کاربر به فرایندی گسترده برای بازخوانی اسناد تاریخی تبدیل میشد.
پروژهی reCAPTCHA به سرپرستیلوئیس فون آندر دانشگاه کارنگی ملون شکل گرفت. پژوهشگران در مقالهای که سال ۲۰۰۸ در نشریهی Science منتشر شد، گزارش کردند که این سامانه توانسته بیش از ۴۴۰ میلیون کلمه را بازخوانی کند و دقت آن در تشخیص کلمات از ۹۹ درصد فراتر رفته است.
گوگل در سال ۲۰۰۹ شرکت reCAPTCHA را خرید. در آن زمان، این فناوری در بیش از ۱۰۰ هزار وبسایت برای جلوگیری از هرزنامه و فعالیت رباتها استفاده میشد.
گوگل دربیانیهی رسمی خرید reCAPTCHAتوضیح داد که قصد دارد از این فناوری برای بهبود دیجیتالیکردن کتابها و آرشیو روزنامهها استفاده کند. تبدیل تصاویر اسکنشده به متن، جستوجو در محتوای کتابها و دسترسی افراد نابینا و کمبینا به آنها را آسانتر میکرد.
با پیشرفت فناوری تشخیص متن و هوش مصنوعی، روشهای کپچا نیز تغییر کردند. گوگل بهتدریج از آزمونهای مبتنی بر کلمات ناخوانا فاصله گرفت و به روشهایی مانند انتخاب تصاویر، بررسی رفتار کاربر و تأیید نامحسوس انسانبودن روی آورد.
بنابراین، کپچاهایی که امروزه در وبسایتها میبینیم لزوماً برای دیجیتالیکردن کتابها استفاده نمیشوند.
بااینحال، reCAPTCHA قدیمی نمونهای جالب از استفادهی جمعی از توانایی انسانها برای حل مسئلهای بود که کامپیوترهای آن زمان در انجامش مشکل داشتند. میلیونها نفر، بدون آنکه متوجه باشند، هنگام ورود به وبسایتها بخشی از نوشتههای فراموششدهی کتابها و روزنامههای تاریخی را دوباره خواندنی میکردند.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.