تراشههای هوش مصنوعی گوگل وارد دیتاسنترهای متا شدند
گوگل با پشتیبانی بومی PyTorch روی تراشههای TPU، اجرای مدلهای هوش مصنوعی در دیتاسنترهای متا را ممکن و رقابت با انویدیا را تشدید میکند. تکناک گوگل در وبلاگ توسعهدهندگان خود اعلام کرده است که نسخه جدید SGLang با نام SGLang-TorchTPU برای اجرای مستقیم روی TPU…
خلاصه تحلیلی خبر
گوگل با پشتیبانی بومی PyTorch روی تراشههای TPU، اجرای مدلهای هوش مصنوعی در دیتاسنترهای متا را ممکن و رقابت با انویدیا را تشدید میکند. تکناک گوگل در وبلاگ توسعهدهندگان خود اعلام کرده است که نسخه جدید SGLang با نام SGLang-TorchTPU برای اجرای مستقیم روی TPU…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، گوگل، متا، PyTorch، مدلهای
گوگل با پشتیبانی بومیPyTorchروی تراشههایTPU، اجرای مدلهای هوش مصنوعی در دیتاسنترهای متا را ممکن و رقابت با انویدیا را تشدید میکند.
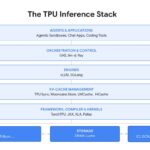
تکناکگوگل در وبلاگ توسعهدهندگان خود اعلام کرده است که نسخه جدید SGLang با نام SGLang-TorchTPU برای اجرای مستقیم روی TPU و با پشتیبانی بومی از چارچوب PyTorch توسعه یافته است. نسخه متنباز موتور استنتاج vLLM نیز با قابلیت مشابه معرفی شده است.
پیشاز این، اجرای این دو موتور روی تراشههای گوگل به چارچوب هوش مصنوعی JAX متکی بود. نسخههای جدید به توسعهدهندگان اجازه میدهند مدلهای مبتنیبر PyTorch را با تغییرات بسیار محدود روی TPU اجرا کنند و در بسیاری از موارد، نیازی به بازنویسی کدهای موجود نداشته باشند.
همکاری گوگل و متا برای کاهش وابستگی به انویدیا
زونگوی ژو، مسئول بخش PyTorch-TPU در متا، اعلام کرده است که SGLang-TorchTPU هماکنون در محیط عملیاتی این شرکت اجرا میشود. به گفته او، این پروژه نتیجه همکاری نزدیک متا، گوگل و تیم SGLang است و زیرساختی بالغ برای اجرای مدلهای PyTorch فراهم میکند.
توسعه موتور SGLang بر عهده شرکت نوپای RadixArk بوده است که بنیانگذاران SGLang آن را تأسیس کردهاند. این شرکت با همکاری گوگل و متا، نسخه جدید را توسعه داده است. گوگل همچنین تأیید کرده که TorchTPU را با مشارکت تیم PyTorch متا ساخته است.
جانا ون گرونن، مدیر مهندسی PyTorch در متا، نیز تأکید کرده است که این شرکت نمیتواند به یک معماری سختافزاری محدود بماند. TorchTPU به متا امکان میدهد بارهای کاری مبتنیبر PyTorch را روی تراشههای گوگل اجرا کند.
متا پیشاز این هم تجربه استفاده از TPU را داشته است. این شرکت بین سالهای ۲۰۲۰ تا ۲۰۲۳ از طریق ابزار PyTorch/XLA، پلی نرمافزاری میان PyTorch و TPU، از این تراشهها در تیمهای تحقیقاتی خود استفاده میکرد. بااینحال، قراردادهای مربوط به این همکاری بعداً لغو شدند. به نظر میرسد گوگل با توسعه TorchTPU قصد دارد مانع نرمافزاری مهمی که متا را از استفاده گستردهتر از TPU بازمیداشت، برطرف کند.
جزئیات محل استقرار تراشههای مورد استفاده متا هنوز مشخص نیست. گزارشهای پیشین از مذاکرات برای اجاره TPUهای Google Cloud در سال ۲۰۲۶ و خرید آنها در سال ۲۰۲۷ خبر داده بودند. همچنین گزارش شده است که متا بعدها قراردادی چندساله برای اجاره این تراشهها امضا کرده است.
بیشتر بخوانیدآمازون با ابزار TorchNeuron سلطه انویدیا بر هوش مصنوعی را بهچالش میکشد
رقابت گوگل و آمازون با اکوسیستم نرمافزاری انویدیا
این اعلام تنها یک روز پس از آن منتشر شد که آمازون از متنباز کردن TorchNeuron، بکاند بومی PyTorch برای تراشههای Trainium2 و Trainium3، خبر داد. هر دو اقدام در کنفرانس PyTorch معرفی شدند و هدف مشترک آنها فراهم کردن امکان اجرای مدلهای هوش مصنوعی روی سختافزارهای جایگزین انویدیا است.
یکی از مزیتهای اصلی انویدیا، علاوهبر قدرت پردازشی تراشهها، اکوسیستم نرمافزاری گسترده آن است. ابزارهایی مانند CUDA باعث شدهاند توسعهدهندگان برای اجرای مدلهای هوش مصنوعی به زیرساخت این شرکت وابستگی زیادی داشته باشند. پشتیبانی مستقیم از PyTorch روی تراشههای رقیب میتواند هزینه و پیچیدگی مهاجرت را کاهش دهد.
بیشتر بخوانیدمتا به پرداخت ۲۵ میلیارد دلار جریمه در پرونده حریم خصوصی محکوم شد
عملکرد TPUهای گوگل در اجرای مدلهای بزرگ
طبق گزارشی از شرکت Inferact، نسخه بهینهشده vLLM روی نسل هفتم TPUهای گوگل، موسوم به Ironwood، توانسته است مدل متنباز Kimi K3 با ۲.۸ تریلیون پارامتر را با سرعت بیش از ۷۰۰ توکن در ثانیه برای یک کاربر اجرا کند.
این آزمایش با استفاده از ۱۶ تراشه Ironwood و روش رمزگشایی حدسی (Speculative Decoding) انجام شده است. در مقایسه، پیکربندی منتشرشده vLLM روی ۱۶ پردازنده گرافیکی Nvidia GB200 به سرعت ۴۵۲ توکن در ثانیه رسیده بود. بااینحال، چون آزمایش TPU از رمزگشایی حدسی استفاده کرده است، این اعداد بهتنهایی مقایسهای کاملاً همشرایط محسوب نمیشوند.
Inferact همچنین اعلام کرده است که کرنلهای بهینهشده آن برای مدلهای Kimi K3 و Qwen 3.8 27B، در اندازههای کوچک دسته پردازشی و بدون رمزگشایی حدسی، حدود ۱.۴ تا ۲ برابر توان عملیاتی پیکربندی پایه GB200 را ارائه میکنند. این نتایج به تنظیمات آزمایش و نوع مدل وابستهاند و لزوماً نشاندهنده برتری TPU در همه بارهای کاری نیستند.
بیشتر بخوانیدمعرفی نسل جدید تراشههای TPU گوگل برای افزایش قدرت پردازش
پشتیبانی از مدلهای جدید در سال ۲۰۲۷
توسعهدهندگان SGLang-TorchTPU قصد دارند مدلهای بیشتری را به این زیرساخت اضافه کنند. DeepSeek V4.1 Flash و Reflection Beam از جمله مدلهایی هستند که پشتیبانی از آنها در برنامه قرار دارد.
RadixArk همچنین در تلاش است تا امکان پشتیبانی از مدلهای متنباز جدید را از همان روز انتشار فراهم کند. هدف این شرکت رسیدن به این قابلیت تا سهماهه نخست سال ۲۰۲۷ است.
گوگل، متا و RadixArk قرار است جزئیات بیشتری از همکاری خود را در رویداد SGLang Summit 2026، در روزهای ۱۲ و ۱۳ نوامبر در سانفرانسیسکو، منتشر کنند. اگر این تلاشها به گسترش استفاده عملیاتی از TPU منجر شوند، انویدیا ممکن است در بخشی از بازار هوش مصنوعی با رقابت جدیتری روبهرو شود.
نوشتهتراشههای هوش مصنوعی گوگل وارد دیتاسنترهای متا شدنداولین بار درTechnoc. پدیدار شد.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.