ردپای تراشههای بلکول انویدیا در آموزش DeepSeek و Kimi شناسایی شد
پژوهشگران با استفاده از روشی جدید برای شناسایی اثر انگشت سختافزاری مدعی شدهاند که مدلهای هوش مصنوعی چینی مانند DeepSeek V4 و Kimi با پردازندههای گرافیکی بلکول انویدیا آموزش دیدهاند . تکناک گروه پژوهشی مستقل UnemploymentLabs شواهدی ارائه کرده است که نشان…
خلاصه تحلیلی خبر
پژوهشگران با استفاده از روشی جدید برای شناسایی اثر انگشت سختافزاری مدعی شدهاند که مدلهای هوش مصنوعی چینی مانند DeepSeek V4 و Kimi با پردازندههای گرافیکی بلکول انویدیا آموزش دیدهاند . تکناک گروه پژوهشی مستقل UnemploymentLabs شواهدی ارائه کرده است که نشان…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، استفاده، انویدیا، بلکول، آنها
پژوهشگران با استفاده از روشی جدید برای شناسایی اثر انگشت سختافزاری مدعی شدهاند که مدلهای هوش مصنوعی چینی مانندDeepSeek V4وKimiبا پردازندههای گرافیکی بلکول انویدیا آموزش دیدهاند.
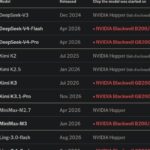
تکناکگروه پژوهشی مستقل UnemploymentLabs شواهدی ارائه کرده است که نشان میدهد تراشههای بلکول انویدیا برای آموزش مدلهای هوش مصنوعی با وزنهای باز چین، از جمله DeepSeek V4، Kimi K3.1، MiniMax-M3 و Ling-3.1-Flash استفاده شدهاند.
پژوهشگران در بیان نتایج خود جانب احتیاط را رعایت کردهاند. آنها تأکید میکنند که اگرچه محاسباتشان درست است، یافتههای این پژوهش مشخص نمیکند تراشهها کجا قرار داشتهاند، چگونه به آنها دسترسی پیدا شده یا اینکه آیا قوانین کنترل صادرات نقض شدهاند یا خیر.
تا جایی که اطلاعات موجود نشان میدهد، اجاره سختافزار بلکول در خارج از چین توسط شرکتهای چینی در حال حاضر غیرقانونی نیست. همچنین شرکتهای آمریکایی نیز بهطور کامل از انجام چنین معاملاتی منع نشدهاند. توافق اخیر تنسنت و اوراکل نمونهای از این وضعیت است.
روش شناسایی پژوهشگران فقط برای مدلهایی کاربرد دارد که وزنهای آنها بهصورت عمومی منتشر شده است. این روش همچنین به ترکیب سختافزار و نرمافزار مورد استفاده برای آموزش مدل بستگی دارد. بااینحال، محققان روشی ساده اما هوشمندانه برای شناسایی سختافزار مورد استفاده پیدا کردهاند.
اثر انگشت سختافزاری چگونه تراشههای انویدیا را شناسایی میکند؟
برای درک این روش، ابتدا باید چند نکته درباره معماری پردازندههای گرافیکی انویدیا بدانیم. خانوادههای مختلف شتابدهندههای هوش مصنوعی این شرکت تعداد متفاوتی واحد پردازشی سایهزن یا SM دارند. این واحدها تا حدی به هستههای پردازندههای مرکزی شباهت دارند.
تراشههای هاپر انویدیا ۱۳۲ واحد SM دارند، درحالیکه این تعداد در سری بلکول B به ۱۴۸ و در تراشههای بلکول GB به ۱۵۲ واحد میرسد. از طرف دیگر، اگرچه ابزارهای نرمافزاری مختلفی برای آموزش مدلهای هوش مصنوعی وجود دارند، PyTorch و ابزارهای سازگار با CUDA از رایجترین گزینهها در سختافزار انویدیا محسوب میشوند.
فرایند آموزش یک مدل با مقداردهی اولیه به وزنهای آن آغاز میشود. وزنها مشخص میکنند مدل تا چه اندازه به ورودیهای مختلف اهمیت بدهد. در معماریهای امروزی مدلهای زبانی بزرگ، این مرحله شامل تصادفیسازی مقادیر وزنها با استفاده از کتابخانه cuRAND است.
این تصادفیسازی کاملاً بیقاعده نیست. یک مقدار اولیه به نام Seed باعث میشود اعداد تصادفی تولیدشده در هر بار اجرای فرایند، یکسان باشند.
از آنجا که مقداردهی اولیه وزنهای یک مدل بزرگ به توان پردازشی زیادی نیاز دارد، این فرایند میان تمام واحدهای SM و رشتههای پردازشی آنها تقسیم میشود. برای مجموعههای بزرگ وزن، تعداد رشتههای پردازشی بهازای هر واحد SM در تراشههای بلکول و هاپر ۲۰۴۸ رشته است.
پژوهشگران با استفاده از همان تراشهها، نرمافزارها و تعداد رشتههای پردازشی، نمونهای مشابه از فرایند مقداردهی اولیه را اجرا کردند. سپس با انجام تحلیلهای آماری نسبتاً ساده، متوجه شدند توزیع آماری نهایی مقادیر وزنها دقیقاً با الگوی مشاهدهشده در مدلهای DeepSeek، Kimi و سایر مدلها مطابقت دارد.
آنها برای اطمینان از نتیجه، تعداد واحدهای SM و رشتههای پردازشی را تغییر دادند. همانطور که انتظار میرفت، با تغییر این مقادیر، همبستگی آماری بهطور کامل از بین رفت.
بیشتر بخوانیدخروج جنسن هوانگ از انویدیا چه پیامدهایی برای صنعت هوش مصنوعی دارد؟
شناسایی خانواده تراشهها و محدودیتهای روش پژوهش
این روش به محققان اجازه داد خانواده تراشههای بلکول و هاپر مورد استفاده برای آموزش هر مدل را شناسایی کنند. آنها همچنین توانستند تعداد تقریبی کارتهای گرافیکی بهکاررفته را تخمین بزنند.
بااینحال، این تحلیل مشخص نمیکند دقیقاً کدام نسخه از یک کارت گرافیک برای تولید وزنهای مدل استفاده شده است. دلیل این محدودیت آن است که روش پژوهش فقط به تعداد واحدهای SM و الگوی استفاده از آنها وابسته است و ویژگیهایی مانند ظرفیت حافظه ویدئویی (VRAM)، پهنای باند حافظه و سایر مشخصات اختصاصی کارتها را بررسی نمیکند.
بیشتر بخوانیدانویدیا عرضه RTX 5080 با حافظه ۲۴ گیگابایتی را متوقف کرد
پژوهشگران احتمال استفاده از کارتهای AMD مانند MI300X یا سایر تراشههایی را که تعداد واحدهای SM بالایی دارند نیز بررسی کردهاند. از نظر تئوری، غیرممکن نیست که یک کارت AMD بهگونهای پیکربندی شود که مانند دو گروه ۱۴۸ یا ۱۵۲ واحدی از واحدهای پردازشی ظاهر شود، هرچند انگیزه مشخصی برای چنین کاری وجود ندارد.
بااینحال، محققان در مورد DeepSeek V4 این احتمال را نیز بررسی و رد کردهاند. آنها با تحلیل مستقیم مقادیر وزنهای مدل دریافتند که کارتهای AMD الگوی مقادیر مشابهی تولید نمیکنند.
با وجود این یافتهها، پژوهشگران تأکید دارند که روش اثر انگشت سختافزاری بهتنهایی نمیتواند محل استفاده از تراشهها یا نقض قوانین صادراتی آمریکا را اثبات کند.
بیشتر بخوانیدانویدیا دسترسی چین به پردازندههای هوش مصنوعی را محدود کرد
نوشتهردپای تراشههای بلکول انویدیا در آموزش DeepSeek و Kimi شناسایی شداولین بار درTechnoc. پدیدار شد.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.