آیا هوش مصنوعی واقعاً یاد میگیرد؟ شکاف بزرگ در طراحی «لحظه ChatGPT» XNET | اخبار و تحلیل هوش مصنوعی
رباتهای هوش مصنوعی برخلاف انسانها، فرآیند یادگیری مستمر و لحظهای ندارند و تنها بر اساس دادههای تثبیتشده در مرحله آموزش پاسخ میدهند؛ این یک نقص ساختاری است. پس از کلی بررسی منابع معتبر و تحلیل دادهها مشخص شده است که آنچه ما در عصر فعلی به عنوان «هوش» در…
خلاصه تحلیلی خبر
رباتهای هوش مصنوعی برخلاف انسانها، فرآیند یادگیری مستمر و لحظهای ندارند و تنها بر اساس دادههای تثبیتشده در مرحله آموزش پاسخ میدهند؛ این یک نقص ساختاری است. پس از کلی بررسی منابع معتبر و تحلیل دادهها مشخص شده است که آنچه ما در عصر فعلی به عنوان «هوش» در…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، هوش، یادگیری، مصنوعی، مدل
رباتهای هوش مصنوعی برخلاف انسانها، فرآیند یادگیری مستمر و لحظهای ندارند و تنها بر اساس دادههای تثبیتشده در مرحله آموزش پاسخ میدهند؛ این یک نقص ساختاری است.
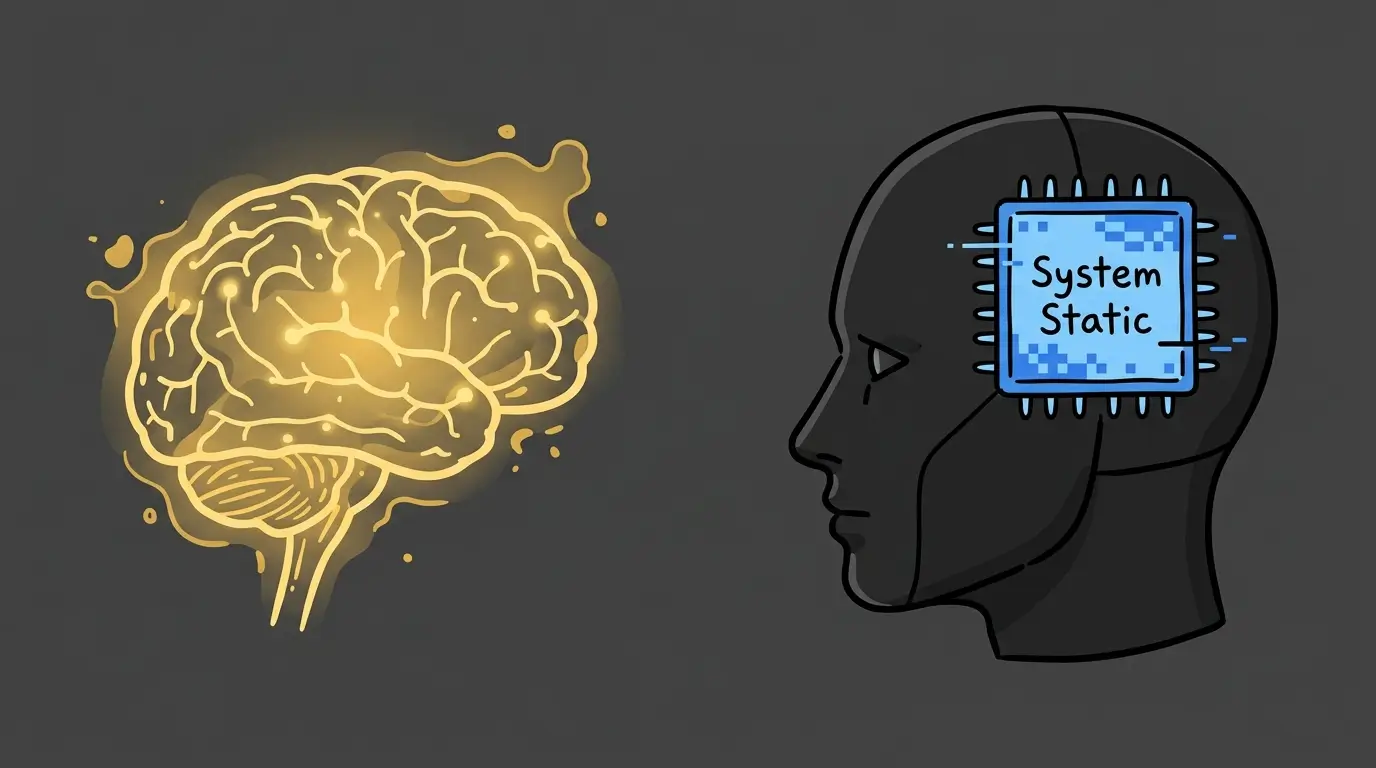
پس از کلی بررسی منابع معتبر و تحلیل دادههامشخص شده است که آنچه ما در عصر فعلی به عنوان «هوش» در مدلهایی مثل ChatGPT یا Gemini تجربه میکنیم، در واقع یک بازنمایی آماری بسیار پیشرفته از دادههای گذشته است. در دنیای فناوری، اصطلاح «لحظه ChatGPT» به نقطهای اشاره دارد که هوش مصنوعی از یک ابزار آزمایشگاهی به یک همراه روزمره تبدیل شد. اما این تحول بزرگ، یک حفره عظیم در زیر بنای خود دارد: این سیستمها برخلاف مغز ما، در حین تعامل با جهان، چیزی یاد نمیگیرند.
توهم هوش؛ تفاوت پردازش با یادگیری
وقتی با یک مدل زبانی بزرگ (LLM) صحبت میکنید، ممکن است احساس کنید در حال گفتگو با موجودی هستید که هر لحظه در حال درک شماست. اما واقعیت فنی بسیار متفاوت است. مدلهای فعلی بر پایه معماری ترنسفورمر (Transformer) بنا شدهاند که در طی یک دوره آموزشی سنگین، میلیاردها رابطه بین کلمات را یاد گرفته و آنها را در قالب «وزنهای عددی» (Weights) ذخیره کردهاند.
نکته کلیدی اینجاست: زمانی که آموزش یک مدل تمام میشود، آن مغز دیجیتال «منجمد» میشود. وقتی شما به ChatGPT میگویید که امروز باران میبارد، او این اطلاعات را در حافظه بلندمدت خود ذخیره نمیکند تا فردا از آن استفاده کند. او فقط این اطلاعات را در “پنجره بافت” (Context Window) همان گفتگو نگه میدارد. به محض اینکه چت جدیدی باز کنید، او دوباره به همان نسخه منجمد قبلی برمیگردد. این یعنی ما با یک سیستم «دانش ایستا» روبرو هستیم، نه یک «هوش پویا».
چرا انسانها و رباتها در یک مسیر نیستند؟ (تحلیل مقایسهای)
برای درک عمق این شکاف، باید به ساختار بیولوژیکی مغز انسان و ساختار ریاضی مدلهای هوش مصنوعی نگاه کنیم. انسانها دارای پدیدهNeuroplasticityیا انعطافپذیری عصبی هستند؛ یعنی هر تجربه جدید، مسیرهای فیزیکی جدیدی در مغز میسازد. اما در هوش مصنوعی، تغییر در مسیرها نیازمند یک فرآیند بازآموزی (Retraining) بسیار پرهزینه است.
در جدول زیر، تفاوتهای بنیادین این دو فرآیند را با دقت بررسی کردهایم
| پارامتر مقایسه | یادگیری بیولوژیکی (انسان) | یادگیری دیجیتال (LLM فعلی) |
| ماهیت یادگیری | پویا، لحظهای و مستمر | ایستا، دورهای و مرحلهای |
| نیاز به انرژی | بسیار کم (حدود ۲۰ وات) | بسیار عظیم (مگاواتها انرژی) |
| ساختار حافظه | ترکیبی از حافظه کاری و بلندمدت | وزنهای ثابت و پنجره بافت محدود |
| تأثیر خطا | اصلاح مسیر از طریق تجربه | نیاز به بازآموزی یا Fine-tuning |
| انعطافپذیری | قابلیت یادگیری همزمان چند مهارت | احتمال بروز “فراموشی فاجعهبار” |
مانع بزرگ: معمای فراموشی فاجعهبار (Catastrophic Forgetting)
یکی از بزرگترین چالشهایی که مهندسان هوش مصنوعی در سالهای ۲۰۲۵ و ۲۰۲۶ با آن دست و پنجه نرم میکنند، پدیدهای است که به آنCatastrophic Forgettingمیگوییم.
در یادگیری ماشین، اگر بخواهیم یک مدل را که قبلاً در حل مسائل ریاضی استاد بوده، آموزش دهیم تا شعر بنویسد، ممکن است مدل تمام دانش ریاضی خود را از دست بدهد! این اتفاق به این دلیل میافتد که آموزش اطلاعات جدید، وزنهای قبلی را به شدت تغییر میدهد و تعادل ریاضی مدل را به هم میزند. این دقیقاً نقطه مقابل یادگیری انسانی است. ما با یادگیری رانندگی، فراموش نمیکنیم که چگونه صحبت کنیم؛ اما رباتها این توانایی را ندارند. این نقص نشان میدهد که معماری فعلی، محدودیتهای جدی در مسیر رسیدن به هوش عمومی مصنوعی (AGI) دارد.
اقتصادِ یادگیری: چرا رباتها “بیدرس” میمانند؟
شاید بپرسید: «چرا شرکتهایی مثل OpenAI یا گوگل، رباتها را در لحظه آموزش نمیدهند؟» پاسخ در اقتصاد و سختافزار نهفته است.
آموزش یک مدل در مقیاس بزرگ، نیازمند هزاران پردازنده گرافیکی (GPU) قدرتمند و میلیونها دلار هزینه برق و سختافزار است که ماهها طول میکشد. انجام این کار به صورت لحظهای یا روزانه، از نظر اقتصادی و فنی غیرممکن است. بنابراین، شرکتها ترجیح میدهند یک نسخه ثابت و “ایمن” را منتشر کنند، حتی اگر این نسخه از دنیای واقعی عقب مانده باشد. این همان شکافی است که باعث میشود هوش مصنوعی در برابر اتفاقات لحظهای، همیشه کمی “کند” و “بیخبر” به نظر برسد.
راهکارهای میانبر: تکنولوژی RAG و توهم حافظه
برای پوشش دادن این نقص، صنعت فناوری به سمت روشی به نامRAG (Retrieval-Augmented Generation)یا “تولید تقویتشده با بازیابی” حرکت کرده است. در این روش، به جای اینکه مدل واقعاً یاد بگیرد، به او یک “کتابخانه خارجی” (مثل اینترنت یا دیتابیس شرکت) متصل میکنند.
وقتی شما سوالی میپرسید، ربات ابتدا در این کتابخانه جستجو میکند، اطلاعات را میخواند و سپس به شما پاسخ میدهد. این کار باعث میشود ربات به نظر برسد که “دانسته” است، اما در حقیقت او فقط یک “کتابدار بسیار سریع” است که از روی متنها برای شما میخواند. او دانش جدید را به درون هسته خود اضافه نکرده است؛ او فقط از آن استفاده کرده است.
فراتر از الگوریتمها؛ مسیر دشوار به سوی هوش واقعی
در نهایت، باید گفت که “لحظه ChatGPT” آغاز یک عصر جدید بود، اما نه پایان مسیر. اگر میخواهیم به هوش عمومی (AGI) برسیم، باید از مدلهای “آموزش-استفاده” (Train-then-use) عبور کنیم و به سمت مدلهای “یادگیری-در-لحظه” (Online Learning) حرکت کنیم.
بدون حل مسئله فراموشی فاجعهبار و کاهش هزینه محاسباتی برای یادگیری مستمر، هوش مصنوعی همیشه در سطح یک دستیار بسیار باهوش باقی خواهد ماند، اما هرگز به یک موجود هوشمند که با هر تجربه رشد میکند، تبدیل نخواهد شد.
سوالات متداول
خیر، او فقط اطلاعات را از طریق ابزارهای جستجو میخواند، اما ساختار ذهنی خود را تغییر نمیدهد.
انسان در لحظه و با تجربه یاد میگیرد، اما ماشین نیاز به دادههای عظیم و آموزش مجدد سنگین دارد.
این مشکل زمانی رخ میدهد که یادگیری یک موضوع جدید، باعث از دست رفتن اطلاعات قبلی مدل شود.
خیر، RAG فقط مانند یک کتاب باز عمل میکند که ربات از آن استفاده میکند، اما دانش داخلی مدل تغییر نمیکند.
نیاز به معماریهایی داریم که بتوانند بدون بازآموزی سنگین، در حین تعامل با محیط یاد بگیرند.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.