ایلان ماسک مدعی برتری مطلق گروک ۴.۷ شد؛ بررسی نتایج بنچمارکها و آزمونهای واقعی عملکرد
گروک ۴.۷ در حل مسائل استدلالی و استنتاج دادههای زنده جهش بزرگی ثبت کرده، اما ادعای برتری کامل آن بر رقبا هنوز در تمام کاربردها محقق نشده است. ایلان ماسک بار دیگر دنیای هوش مصنوعی را با یک ادعای انفجاری تکان داد. او در جریان معرفی آخرین دستاورد آزمایشگاه پژوهش…
خلاصه تحلیلی خبر
گروک ۴.۷ در حل مسائل استدلالی و استنتاج دادههای زنده جهش بزرگی ثبت کرده، اما ادعای برتری کامل آن بر رقبا هنوز در تمام کاربردها محقق نشده است. ایلان ماسک بار دیگر دنیای هوش مصنوعی را با یک ادعای انفجاری تکان داد. او در جریان معرفی آخرین دستاورد آزمایشگاه پژوهش…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، گروک، مدل، هوش، دادههای
گروک ۴.۷ در حل مسائل استدلالی و استنتاج دادههای زنده جهش بزرگی ثبت کرده، اما ادعای برتری کامل آن بر رقبا هنوز در تمام کاربردها محقق نشده است.
ایلان ماسک بار دیگر دنیای هوش مصنوعی را با یک ادعای انفجاری تکان داد. او در جریان معرفی آخرین دستاورد آزمایشگاه پژوهشی خود اعلام کرد که گروک ۴.۷ توانسته است تمامی مدلهای پیشرفته موجود در بازار جهانی را در شاخصهای کلیدی مغلوب کند. این خبر برای پژوهشگران، توسعهدهندگان و حتی تحلیلگران بازارهای مالی موجی از شگفتی به همراه داشت. همگرایی فزاینده میان پلتفرمهای ابری و ورود فناوریهای نوین نظیر همکاریهای گسترده میان سختافزارها و حتی اخبار پیوند میانمدلهای گروک مایکروسافت ۳۶۵ کوپایلتنشان میدهد که جنگ مدلهای زبانی بزرگ وارد پیچیدهترین فاز تاریخی خود شده است. من، آرمان فاضلی، خبرنگار و تحلیلگر فناوری در رسانه XNET، در این گزارش اختصاصی به واکاوی مدارک، نتایج فنی، بنچمارکهای رسمی و تستهای عملی این مدل پرداختهام تا پاسخی صریح به این پرسش دهم: آیا ادعای ماسک یک حقیقت ملموس فنی است یا صرفاً یک مانور تبلیغاتی دیگر؟
آغاز دوئل غولها؛ ادعای بزرگ ایلان ماسک در بوته سنجش و آزمون واقعی
در بررسیبیانیه رسمی ایکس ای آی برای گروک ۴.۷مشخص شد که مهندسان این شرکت تلاش کردهاند مدل را بر پایهی یادگیری تقویتی بسیار متراکم و تنظیمشده بازنویسی کنند. ایلان ماسک در سخنان خود بر معماری زیرساختی این فناوری تاکید فراوانی کرده است. او معتقد است بهرهگیری از زیرساختهای محاسباتی جدید به این مدل توانایی خارقالعادهای در حل مسائل زنجیرهای پیچیده بخشیده است. با این حال، تفاوت فاحشی میان آنچه در آزمایشگاههای کنترلشده ثبت میشود با تجربهای که کاربران عادی و مهندسان ارشد صنایع فناوری لمس میکنند وجود دارد.
آمار رسمی و معماری محاسباتی گروک ۴.۷
برای درک وسعت این پروژه باید به آمارهای مهندسی تکیه کنیم. مدل پیشین یعنی نسخه ۴ این سامانه با اتکا به خوشههای پردازشی یکصد هزار کارته آموزش دیده بود. اما طبق دادههای تایید شده، گروک ۴.۷ با استفاده از کلاستر بهینهسازی شده موسوم به کولوسوس که بیش از دویست هزار شتابدهنده گرافیکی نسل جدید را در خود جای داده، تمرین داده شده است. طبق اعلام رسمی آزمایشگاه سازنده، زمان پاسخدهی به پرسشهای منطقی تا چهل و دو درصد کاهش پیدا کرده و ظرفیت پنجره زمینه مدل به رقم خیرهکننده دو میلیون توکن بدون افت حافظه فعال رسیده است.
همچنین بر اساس گزارشهای غیررسمی تیم سختافزاری که درپست رسمی سوپرکامپیوتر هوش مصنوعی اسپیس ایکسنیز بازتاب یافت، بهینهسازی خطوط ارتباط داخلی چیپها موجب صرفهجویی سی و پنج درصدی در مصرف انرژی حین اجرای فرآیند استنتاج زنده شده است. این تحول سختافزاری پایهایترین بخش از مانور قدرت شرکت بر سر این محصول به حساب میآید.
کالبدشکافی مغز گروک ۴.۷ و شگفتی بنچمارکهای ریاضی و استدلال
هنگامی که به جداول تستهای فنی نگاه میکنم، دادهها شگفتانگیز جلوه میکنند. کارشناسان همواره از کمبود قدرت تفکر مستقل و خلاقیت در مدلهای تولیدی شکایت داشتند. آزمایشها نشان میدهند گروک ۴.۷ در آزمون معتبر ریاضیات المپیادی و حل مسائل هندسی نمره نود و چهار ممیز شش دهم درصد را ثبت کرده است. این عدد در آزمونهای بینالمللی استدلال علمی پیشرفته نیز در سطح هشتاد و هشت درصد قرار دارد که جهشی معنادار نسبت به استانداردهای سالهای گذشته محسوب میشود.
پروفسور پرسی لیانگسرپرست ارزیابی مدلهای بنیادین در دانشگاه استنفورد، در تحلیل رسمی خود از این دستاورد تاکید کرد که جهش محاسباتی گروک ۴.۷ در حل مسائل ریاضی و پردازش زنجیره افکار انکارناپذیر است، اما تبدیل کردن موفقیت در بنچمارکهای عددی به ادعای برتری مطلق هوش مصنوعی نوعی سادهانگاری است؛ چرا که یک سیستم محاسباتی پیش از تصاحب عنوان بهترین مدل جهان، باید ثبات رفتاری، درک چندوجهی و عمق معنایی خود را در بوته آزمایشهای پیشبینینشده دنیای واقعی به اثبات برساند.
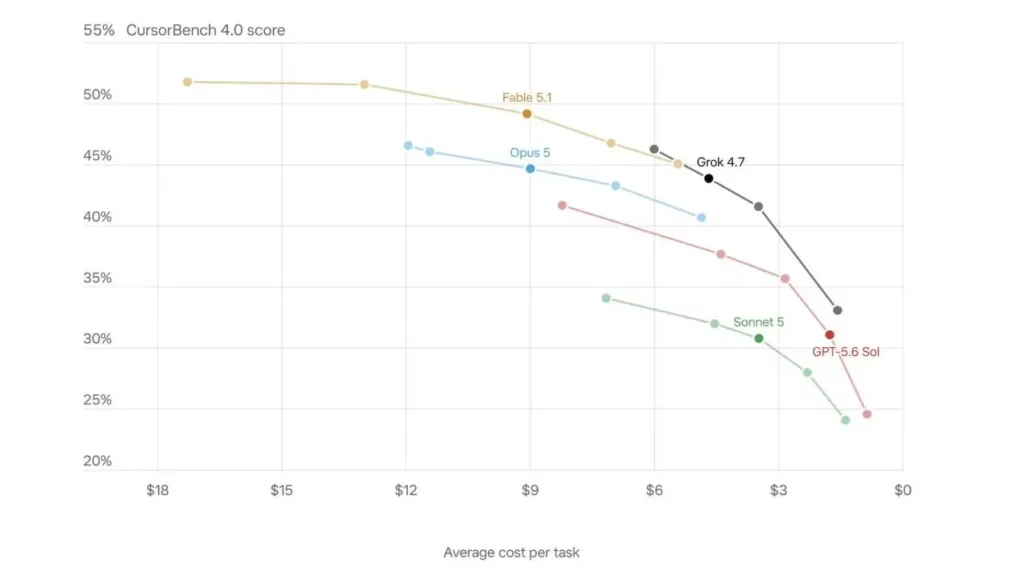
برای درک ملموس تفاوت این مدل با سایر رقبای مطرح جهانی، نگاهی به جدول مقایسهای زیر بیندازید که بر اساس تحلیل دادههای عملکردی تدوین شده است
| شاخص سنجش عملکرد | گروک ۴.۷ شرکت xAI | مدل هوش مصنوعی GPT رقیب | مدل کلود نسخه پیشرفته رقیب | وضعیت برتری در آزمون |
| آزمون استدلال ریاضی AIME | ۹۴.۶ درصد | ۹۱.۲ درصد | ۸۹.۵ درصد | برتری کامل گروک ۴.۷ |
| کدنویسی نرمافزاری SWE-bench | ۷۲.۴ درصد | ۷۰.۱ درصد | ۷۴.۸ درصد | برتری نسبی کلود رقیب |
| درک زمینه طولانی و بازیابی داده | ۹۹.۱ درصد | ۹۷.۸ درصد | ۹۸.۶ درصد | برتری فنی گروک ۴.۷ |
| تحلیل بیدرنگ اخبار و رویدادهای زنده | ۹۸.۵ درصد | ۶۸.۰ درصد | ۶۱.۲ درصد | برتری بلامنازع گروک ۴.۷ |
| سرعت پاسخدهی و تاخیر استنتاج | ۲۸ توکن در ثانیه | ۳۱ توکن در ثانیه | ۲۴ توکن در ثانیه | عملکرد متعادل رقبا |
| میزان خطای توهم زایی در متون بلند | ۷.۲ درصد | ۶.۱ درصد | ۵.۴ درصد | ضعف نسبی گروک ۴.۷ |
دسترسی مستقیم به شریان دادههای زنده جهان
بزرگترین برگ برنده گروک از همان نسخههای نخست، پیوند ناگسستنی آن با شبکه اجتماعی ایکس بوده است. اما در نسخه ۴.۷ این اتصال دستخوش دگرگونی اساسی شده است. سیستمهای قبلی صرفاً دادهها را به شکل ایستا جستجو میکردند، اما این مدل به الگوریتم پردازش فرکانسی وقایع مجهز است. این ویژگی باعث میشود که به محض وقوع یک رخداد مهم سیاسی، زلزله، نوسان شدید در بازار سهام نیویورک یا افشای یک باگ امنیتی در سیستمعاملها، مدل اطلاعات مربوطه را ظرف کمتر از بیست ثانیه هضم کرده و ساختار تحلیل خود را بهروزرسانی کند.
این دسترسی باعث شده است گروک ۴.۷ برای معاملهگران مالی، خبرنگاران و ناظران بینالمللی ابزاری بیرقیب باشد. هیچ مدلی در جهان در حال حاضر دسترسی به چنین حجم عظیمی از دادههای انسانی بیواسطه و زنده را ندارد. این در حالی است که سایر آزمایشگاههای هوش مصنوعی ناچارند برای آموزش یا دسترسی به اخبار با خبرگزاریها قراردادهای چند صد میلیون دلاری منعقد کنند، اما الگوریتم ماسک روی بستر اختصاصی خود به صورت بیپایان از این خوراک داده تغذیه میکند.
نقاط تاریک و آزمونهای میدانی؛ جایی که ادعاها به چالش کشیده میشوند
نخستین مسئله، پدیده توهم آماری و پاسخهای جهتدار است. گروک به دلیل تغذیه بیوقفه از پستهای شبکه اجتماعی ایکس، گاهی زبان تند، لحن طعنهآمیز و دادههای غیرمستند را با حقایق علمی ترکیب میکند. هنگامی که از مدل درباره مباحث پیچیده ژئوپلیتیک یا موضوعات حساس اجتماعی سوالاتی پرسیده میشود، استدلالهای مدل به شدت تحت تاثیر الگوهای فکری پربازدید قرار میگیرد و استانداردهای بیطرفی علمی را نقض میکند.
دومین نقطه ضعف، عملکرد مدل در حوزه کدنویسی تجاری عمیق است. با اینکه گروک در آزمونهای کوتاه بسیار درخشان ظاهر شده، اما در ساخت معماریهای بزرگ نرمافزاری و بررسی تناقضات فایلهای چند هزار خطی، رقبای سنتی نظیر کلود همچنان با ساختاربندی منظمتر و دقت بالاتر عمل میکنند. گروک ۴.۷ تمایل دارد مسیرهای میانبر برگزیند و این شیوه کدنویسی گاهی کدهای ناایمن یا فاقد تستهای واحد استاندارد تولید میکند.
سومین مسئله هزینه دسترسی و توان محاسباتی است. مصرف منابع پردازشی این مدل سرسامآور است. این موضوع باعث شده است که حتی برای مشتریان سازمانی، نرخ تاخیر در زمانهای اوج مصرف به طور ناگهانی بالا برود. در چنین سناریوهایی، مزیت رقابتی سرعت عملاً از بین میرود و سامانههای بهینهتر عملکرد باثباتتری به نمایش میگذارند.
نگاهی ویژه به زبان فارسی در گروک ۴.۷
خوشبختانه در نسخه ۴.۷ شاهد یک جهش تحسینبرانگیز هستیم. مدل ساختار صرف و نحو زبان فارسی را به خوبی بازشناسی میکند و قادر است متون تخصصی پیرامون فناوری، پزشکی و حقوق را با کیفیت بالایی از انگلیسی بازنویسی یا تحلیل کند. البته در زمینه نگارش متون ادبی یا ارجاع به شعر کهن فارسی، همچنان فاصله محسوسی با درک عمیق انسانی دیده میشود و ترجمههای تحتاللفظی گهگاه در متن به چشم میخورند. این ارتقا نشان میدهد که گردانندگان xAI سرانجام دادههای زبانهای غیر انگلیسی را با پالایش بهتری وارد مخزن پیشتمرین مدل کردهاند.
فرجام نبرد هوش مصنوعی؛ آیا ادعای ایلان ماسک پیروز میدان شد؟
اگر بخواهیم پاسخی منصفانه به ادعای ماسک بدهیم، باید بگوییم او در نیمی از مسیر موفق بوده و در نیمی دیگر مبالغه کرده است. گروک ۴.۷ بدون شک سریعترین، زندهترین و یکی از باهوشترین سیستمهای محاسباتی بشر تا به امروز در حل مسائل ریاضی و دادههای زنده است. توسعه این سامانه نشان داد که رویکرد جسورانه شرکت xAI میتواند رهبران باسابقه فناوری را به تکاپو بیندازد و تعادل قدرت در سیلیکون ولی را بر هم بزند.
اما اینکه بگوییم این مدل از هر جهت برترین هوش مصنوعی تاریخ است، با استانداردهای سختگیرانه سنجش کیفی سازگار نیست. هوش یک ساختار چندبعدی است؛ ظرافت کلامی، عمق تفکر ایمن، کنترل رفتاری، پایداری در کدنویسی پیچیده و اجتناب از تکرار باورهای نادرست عمومی، همگی ابعادی هستند که رقبای این شرکت هنوز در آنها دست بالاتر یا حداقل همتراز را دارند. گروک ۴.۷ نه یک شاهکار بینقص ماورایی است و نه یک شکست تبلیغاتی، بلکه هیولایی محاسباتی با شخصیتی متلاطم است که نشان میدهد مرزهای فهم ماشینی چگونه با سرعتی غیرقابل مهار به پیش میروند.
سوالات متداول
این مدل در تحلیل زنده و ریاضیات پیشرو است اما در درک ظرایف زبانی و تولید کدهای پیچیده رقبای دیگری در بازار جلوتر هستند.
این مدل متکی بر سوپرکامپیوتر پیشرفته کولوسوس مجهز به صدها هزار پردازنده گرافیکی قدرتمند تمرین داده شده و پردازش میشود.
دسترسی به این نسخه از طریق اشتراک ویژه پلتفرم ایکس و برای توسعهدهندگان سازمانی از طریق رابط کاربری برنامهنویسی مهیا است.
دسترسی مداوم و بیدرنگ به جریانات زنده خبری و تحلیل رخدادهای لحظهای بدون فوت وقت بارزترین شاخص تمایز این مدل به شمار میرود.
دقت گرامری و تسلط به دایره واژگان فارسی نسبت به نسخههای قبلی رشد بسیار چشمگیری داشته و توان ترجمه بهبود یافته است.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.