معرفی LifeVal؛ معیار جدید OpenAI برای سنجش عملکرد هوش مصنوعی در زندگی روزمره
شرکت OpenAI از معیار جدیدی به نام LifeVal رونمایی کرد که عملکرد مدلهای هوش مصنوعی را در انجام کارهای واقعی زندگی روزمره میسنجد؛ از ثبتنام مهدکودک تا مدیریت امور مالی. این ارزیابی بر پایه دادههای دو مطالعه بزرگ درباره نحوه گذران وقت افراد و یک نظرسنجی تازه…
خلاصه تحلیلی خبر
شرکت OpenAI از معیار جدیدی به نام LifeVal رونمایی کرد که عملکرد مدلهای هوش مصنوعی را در انجام کارهای واقعی زندگی روزمره میسنجد؛ از ثبتنام مهدکودک تا مدیریت امور مالی. این ارزیابی بر پایه دادههای دو مطالعه بزرگ درباره نحوه گذران وقت افراد و یک نظرسنجی تازه…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، امنیت سایبری، LifeVal، OpenAI، مدل
شرکت OpenAI از معیار جدیدی به نامLifeValرونمایی کرد که عملکرد مدلهای هوش مصنوعی را در انجام کارهای واقعی زندگی روزمره میسنجد؛ از ثبتنام مهدکودک تا مدیریت امور مالی.
این ارزیابی بر پایه دادههای دو مطالعه بزرگ درباره نحوه گذران وقت افراد و یک نظرسنجی تازه با ۳٬۹۹۵ پاسخدهنده طراحی شده و حوزههایی را پوشش میدهد که کاربران بیشترین نیاز را به کمک دستیار هوشمند در آنها اعلام کردهاند. OpenAI میگوید LifeVal ابزاری است برای ردیابی میزان توانایی مدلها در به سرانجام رساندن کارهای عملی، نه صرفاً پاسخدادن به پرسشهای آکادمیک.
انتشار این معیار در ادامه مسیری است که اوپنایآی طی یک سال گذشته برای تبدیل ChatGPT از یک ابزار گفتوگومحور به یکدستیار عاملیتمحوردنبال کرده؛ دستیاری که قرار است کار را واقعاً تمام کند، نه اینکه تنها درباره آن توصیه بدهد.
چرا OpenAI سراغ سنجش کارهای روزمره رفت
تمرکز بنچمارکهای رایج هوش مصنوعی تاکنون بیشتر روی سنجش دانش عمومی، استدلال ریاضی، کدنویسی و آزمونهای تخصصی بوده است. اوپنایآی در توضیح LifeVal میگوید این نوع ارزیابیها تصویر کاملی از سودمندی مدل برای کاربر عادی نمیدهند.
برای شناسایی کارهایی که بیشترین اهمیت را در زندگی روزمره دارند، تیم سازنده LifeVal از دو منبع دادهای معتبر شروع کرده استنظرسنجی استفاده از زمان در آمریکا(American Time Use Survey) ومطالعه بینالمللی استفاده از زمان(Multinational Time Use Study). این دو مجموعه داده فهرستی دقیق از فعالیتهای روزانه افراد در جمعیتها، ساعتهای مختلف و فصلهای گوناگون ارائه میکنند.
در گام بعدی، یک نظرسنجی تازه با نمونه نمایشی جمعیتی و ۳٬۹۹۵ پاسخدهنده اجرا شد تا مشخص شود مردم در چه زمینههایی بیشترین تمایل را به کمک گرفتن از دستیار هوشمند دارند. حاصل این فرآیند، مجموعهای از کارها در هفت حوزه اصلی است
- مراقبت از افراد
- سلامت
- آموزش
- امور اداری منزل
- مالی شخصی
- خرید
- دسترسی به خدمات دولتی
نمونههایی از این کارها شامل پیدا کردن مهدکودک، دسترسی به خدمات دولتی، تنظیم بودجه خانوار، آمادهسازی برای مدرسه، اصلاح دستور پخت غذا، سفارش مواد غذایی و طراحی برنامه ورزشی است. به گفته اوپنایآی، LifeVal در طول سال گذشته برای هدایت توسعه مدلها در این حوزهها بهکار گرفته شده و اکنون جزئیات آن علنی میشود.
روند پیشرفت مدلها از GPT-5.2 تا Astra
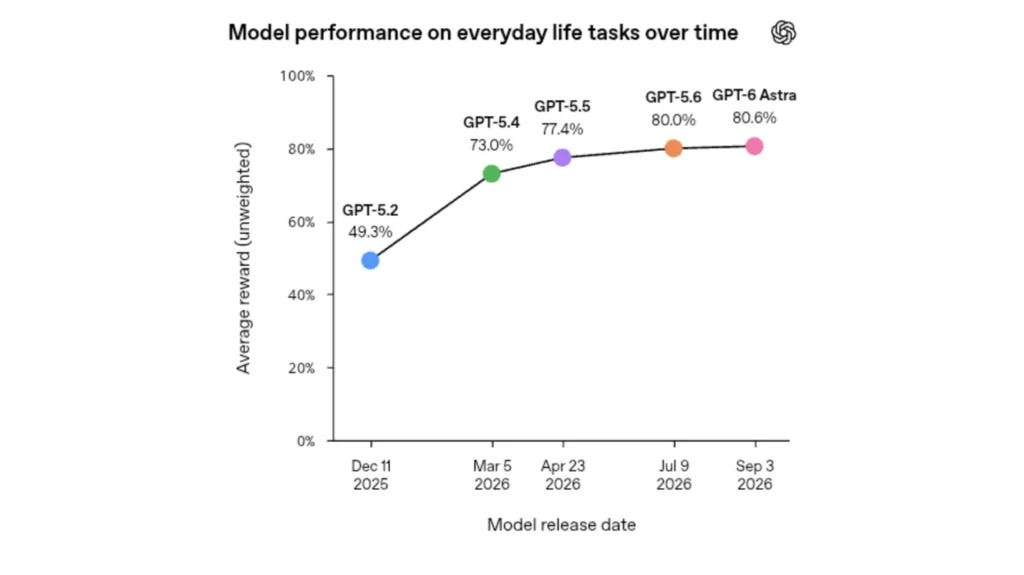
شرکت OpenAI عملکرد چندین نسل از مدلهای خود را روی کارهای LifeVal بررسی کرده است. بازه زمانی این ارزیابی از دسامبر ۲۰۲۵ تا سپتامبر ۲۰۲۶ را در بر میگیرد و شامل مدلهای GPT-5.2، GPT-5.4، GPT-5.5، GPT-5.6GPT-6وAstraمیشود. شاخص اصلی اندازهگیری، میانگین پاداش بدون وزن است.
بر اساس گزارش اوپنایآی، میانگین پاداش از امتیازهای پایه در مدلهای اولیه تا حدود۸۰.۶ درصددر جدیدترین مدلها افزایش یافته است. این رشد عمدتاً حاصل آموزش مدلها در سه حوزه مرتبط با عملگرایی است
- کار با مرورگر
- کنترل رایانه
- استفاده از اتصالات (Connectors)
فعال شدن این قابلیتها در ChatGPT باعث شده مدل بتواند کارهایی را که پیشتر در حد توصیه متنی باقی میماند، بهصورت عملی پیش ببرد؛ از جستوجوی چندمرحلهای تا پر کردن فرم و ثبت درخواست در سامانهها.
مقایسه هزینه و سرعت در API
گزارش OpenAI نشان میدهد در ارزیابی روی API این شرکت، مدلGPT-5.6به عملکرد کلی مشابهی با GPT-6 دست مییابد، در حالی که هزینه تخمینی API آن تقریباً نصف است. در مقابل، GPT-6 حدود۲۳ درصد سریعتراز GPT-5.6 عمل میکند و نتایج را با تأخیر کمتری ارائه میدهد.
این دادهها نشان میدهند توسعهدهندگانی که به دنبال تعادل بین هزینه و کیفیت هستند، میتوانند بر GPT-5.6 تکیه کنند، در حالی که GPT-6 گزینهای برای سناریوهایی است که سرعت پاسخ اهمیت بیشتری دارد. شرکت OpenAI پیشتر در معرفی نسل جدید مدلها نیز بر همین تفکیک میان کارایی هزینه و عملکرد خام تأکید کرده بود.
| مدل | کاربرد شاخص در LifeVal |
|---|---|
| GPT-5.2 تا GPT-5.5 | رشد تدریجی عملکرد از نقطه پایه |
| GPT-5.6 | عملکردی نزدیک به GPT-6 با هزینه API حدود نصف |
| GPT-6 | بالاترین سرعت؛ حدود ۲۳٪ سریعتر از GPT-5.6 |
| Astra | قرار گرفتن در بالاترین سطح میانگین پاداش (حدود ۸۰.۶٪) |
نمونه کارهای عملی و نرخ موفقیت
گزارش OpenAIمجموعهای از جریانهای کاری واقعی را بهعنوان نمونهای از سنجشهای LifeVal منتشر کرده است. این نمونهها نشان میدهند مدلهای کنونی در کارهایی که ترکیبی از جستوجو، تصمیمگیری و اقدام عملی را میطلبند، به نرخ موفقیت بالایی رسیدهاند.
ثبتنام مهدکودک پس از جابهجایی
نرخ موفقیت گزارششده برای این وظیفه۹۳.۱ درصداست. در این سناریو، کاربر از مدل خواسته مهدکودکهای نزدیک به خانه جدید را مقایسه کند و بهترین گزینهها را پیشنهاد دهد. خروجی مدل، گزینهها را به سه مهدکودک محدود و جزئیات ثبتنام را سازماندهی میکند، اما تأکید میکند دو ترجیح باقیمانده نیازمند تماس تلفنی است و پیشنهاد میدهد کاربر فهرست کوتاه را بررسی کند.
مدیریت داوطلبان آمادگی در برابر سیل
این وظیفه با نرخ موفقیت۹۸.۰ درصدیکی از بالاترین امتیازها را در میان نمونههای منتشرشده دارد. مدل باید به سازماندهی نیروی داوطلب در سطح جامعه برای کمک به چهار همسایه در برابر نفوذ آب کمک کند. خروجی شامل یک برنامه اقدام ساده برای ارزیابی مکانها و آمادهسازی در برابر شرایط جوی شدید است.
یافتن خانه مناسب برای خانواده
تنها سناریویی که OpenAI نرخ موفقیت۱۰۰ درصدبرای آن گزارش کرده، جستوجوی خانه در شهرستان لوزان است. کاربر خواسته خانهای در محدوده بودجه، با واحد نشیمن مجزا و با مسیر رفتوآمد کوتاه پس از رساندن بچهها به مدرسه پیدا شود و سند ملکی به سبد خرید سوابق کشوری اضافه شود. مدل این الزامات را اجرا کرده و مالیات نقل و انتقال را نیز محاسبه میکند.
تماشای مشترک مسابقه ورزشی با مادربزرگ از راه دور
این وظیفه با نرخ موفقیت۹۶.۳ درصدانجام شده است. مدل سادهترین تنظیمات پخش را آماده میکند و یک روش پشتیبان نیز در نظر میگیرد تا در صورت خرابی استریم، مراحل بهصورت گامبهگام برای مادربزرگ توضیح داده شود.
تهیه برنامه غذایی برای والد مبتلا به دیابت
در این سناریو با نرخ موفقیت۹۰.۴ درصدمدل یک برنامه هفته اول شامل وعدههای غذایی، یادآوریها و سوالاتی برای تیم مراقبت پزشکی تهیه میکند تا پیش از به اشتراکگذاری با والد، بازبینی شود. این نمونه نشان میدهد LifeVal تنها به کارهای اداری محدود نیست و موقعیتهای حساس سلامت نیز در آن ارزیابی میشوند.
چرا LifeVal برای مسیر AGI اهمیت دارد
شرکت OpenAI مأموریت خود را اطمینان از این میداند که هوش مصنوعی عمومی به نفع تمام بشریت عمل کند و اعلام میکند بیش از یک میلیارد نفر هر هفته از ChatGPT استفاده میکنند. در چنین مقیاسی، سنجش سودمندی واقعی مدل در زندگی کاربر عادی، معیاری متفاوت از آزمونهای تخصصی به شمار میآید.
ارزیابیهایی مانند LifeVal تلاش میکنند فاصله میان «پاسخ درست» و «کار انجامشده» را اندازه بگیرند. وقتی کاربر از دستیار میخواهد خانهای در محدوده بودجه پیدا کند یا برنامه غذایی برای والد مبتلا به دیابت تنظیم شود، موفقیت مدل تنها به دقت متنی خلاصه نمیشود؛ مدل باید جستوجو کند، تصمیم بگیرد، فرم پر کند و در نهایت خروجی قابلاستفاده تحویل دهد.
به همین دلیل، OpenAI روی سه قابلیت استفاده از مرورگر، کنترل رایانه و اتصالات متمرکز شده است. این سه قابلیت، پایه حرکت ChatGPT به سمت یکدستیار عاملیتمحورهستند؛ دستیاری که نه فقط پاسخ میدهد، بلکه بهجای کاربر اقدام میکند.
مسیر معرفی LifeVal همزمان است با عرضه نسل تازهای از مدلهای اوپنایآی. این شرکت پیشتر مدلهایی مانندGPT-6.1 Terraرا برای کاربردهای عمومی ومدلهای اختصاصی امنیت سایبریرا برای حوزههای تخصصی معرفی کرده بود. LifeVal در واقع چارچوبی برای سنجش این است که رشد قابلیتهای فنی تا چه اندازه به بهبود تجربه روزمره کاربر منجر میشود.
محدودیتها و مسیر پیش رو برای LifeVal
نرخ موفقیت بالا در نمونههای منتشرشده نباید به معنای عملکرد بینقص مدلها در همه شرایط تلقی شود. OpenAI خود در توضیح نمونه ثبتنام مهدکودک اشاره میکند که بخشی از کار همچنان نیازمند تماس تلفنی انسان است و مدل تنها گزینهها را محدود و سازماندهی میکند. در نمونه برنامه غذایی دیابت نیز بر ضرورت بازبینی توسط تیم مراقبت پزشکی تأکید شده است.
نکته دیگر این است که دادههای منتشرشده عمدتاً توسط خود OpenAI جمعآوری و ارزیابی شدهاند. تا زمانی که ارزیابیهای مستقل بر روی LifeVal انجام نشود، ارقام نرخ موفقیت باید بهعنوان ادعای سازنده در نظر گرفته شوند، نه نتیجه قطعی عملکرد مدلها در تمام شرایط کاربران.
با این حال، منطق پشت LifeVal جهتگیری مهمی را در صنعت هوش مصنوعی نشان میدهد: حرکت از سنجش دانش انتزاعی به سنجش کار مفید. اگر چنین معیارهایی توسط پژوهشگران مستقل و شرکتهای دیگر نیز پذیرفته شود، میتواند نحوه مقایسه مدلها را تغییر دهد و رقابت را از صرفاً امتیاز بنچمارکهای آکادمیک به سمت کاربرد عملی سوق دهد.
گام بعدی OpenAI برای سنجش سودمندی مدلها
OpenAI اعلام کرده امید دارد LifeVal گامی در مسیر اطمینان از این باشد که پیشرفت هوش مصنوعی در زمینههایی اندازهگیری شود که برای زندگی افراد عادی اهمیت دارد. انتشار جزئیات این ارزیابی به جامعه پژوهشی و توسعهدهندگان این فرصت را میدهد تا فاصله میان ادعاهای عملکردی و تجربه واقعی کاربر را دقیقتر بررسی کنند.
برای کاربر معمولی ChatGPT، پیام عملی این گزارش روشن است: مدلهای جدید روی کارهایی مانند برنامهریزی، جستوجوی چندمرحلهای، سازماندهی اطلاعات و اقدام در مرورگر بهتر عمل میکنند، اما همچنان در موقعیتهای حساس به بازبینی انسانی نیاز است. چارچوب LifeVal، نقطه شروعی برای سنجش این است که این فاصله چگونه و با چه سرعتی در حال کم شدن است.
سوالات متداول
معیاری است که OpenAI برای سنجش عملکرد مدلهای هوش مصنوعی در کارهای واقعی زندگی روزمره مانند ثبتنام، خرید و برنامهریزی طراحی کرده است.
مراقبت از افراد، سلامت، آموزش، امور اداری منزل، مالی شخصی، خرید و دسترسی به خدمات دولتی، بر پایه نظرسنجی با ۳٬۹۹۵ پاسخدهنده.
بر اساس دادههای OpenAI، مدل Astra با میانگین پاداش حدود ۸۰.۶ درصد در بالاترین رده قرار گرفته و GPT-6 نیز سریعترین عملکرد را دارد.
GPT-5.6 عملکردی نزدیک به GPT-6 ارائه میدهد اما هزینه API آن تقریباً نصف است؛ در مقابل، GPT-6 حدود ۲۳ درصد سریعتر عمل میکند.
این شرکت میگوید ارزیابی دانش انتزاعی مدل، میزان سودمندی واقعی آن برای کاربر عادی را نشان نمیدهد و LifeVal این فاصله را میسنجد.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.