چگونه سرعت حلقه های pandas را 71803 برابر افزایش دهیم؟
اگر برای تحلیل دادههای Data analysis خود از پایتون و کتابخانه pandas استفاده میکنید، دیر یا زود مجبور میشوید با حلقه های pandas هم کار کنید. اجرای حلقههای استاندارد برای یک دیتافریم کوچک بسیار زمانبر است بنابراین، اجرای آن برای دیتافریمهای بزرگتر قطعا…
خلاصه تحلیلی خبر
اگر برای تحلیل دادههای Data analysis خود از پایتون و کتابخانه pandas استفاده میکنید، دیر یا زود مجبور میشوید با حلقه های pandas هم کار کنید. اجرای حلقههای استاندارد برای یک دیتافریم کوچک بسیار زمانبر است بنابراین، اجرای آن برای دیتافریمهای بزرگتر قطعا…
موضوعات اصلی: پشتیبانی شبکه، سرعت، اجرای، TEAM، row، FTR
اگر برایتحلیل دادههایData analysisخود از پایتون و کتابخانه pandas استفاده میکنید، دیر یا زود مجبور میشوید با حلقه های pandas هم کار کنید. اجرای حلقههای استاندارد برای یک دیتافریم کوچک بسیار زمانبر است بنابراین، اجرای آن برای دیتافریمهای بزرگتر قطعاً به زمان بیشتری نیاز دارد. وقتی برای اولینبار از یک حلقه استفاده میکنید و مجبور میشوید بیش از نیم ساعت منتظر اجرای آن کد بمانید، بهتر است راهی جایگزین برای این مسئله پیدا کنید.
حلقههای استاندارد
دیتافریمها دارای سطر و ستون هستند و یکی از انواع اشیاء موجود در pandas به شمار میآیند. وقتی از یک حلقه استفاده میکنید، درواقع تمام این شیء را بارها و بارها تکرار میکنید. سرعت پایتون پایین است زیرا نمیتواند از مزایایتوابع تعبیهشدهbuilt-in functionsبهره ببرد. در مثالی که در ادامه به آن خواهیم پرداخت، یک دیتافریم با 1140 سطر و 65 ستون را درنظر میگیریم که حاوی دادههای مربوط به نتایح بازیهای فصلی فوتبال در سالهای 2016 تا 2019 است. ما قصد داریم یک ستون دیگر به این دیتافریم اضافه کنیم که حاوی اطلاعات مربوط به نتایج تساوی بازیهای یک تیم بهخصوص باشد. بدین منظور باید چنین نوشت
def soc_loop(leaguedf,TEAM,): leaguedf['Draws'] = 99999 for row in range(0, len(leaguedf)): if ((leaguedf['HomeTeam'].iloc[row] ==TEAM)& (leaguedf['FTR'].iloc[row] == 'D')) | \ ((leaguedf['AwayTeam'].iloc[row] == TEAM) & (leaguedf['FTR'].iloc[row] == 'D')): leaguedf['Draws'].iloc[row] = 'Draw' elif ((leaguedf['HomeTeam'].iloc[row] == TEAM) & (leaguedf['FTR'].iloc[row] != 'D')) | \ ((leaguedf['AwayTeam'].iloc[row] == TEAM) & (leaguedf['FTR'].iloc[row] != 'D')): leaguedf['Draws'].iloc[row] = 'No_Draw' else: leaguedf['Draws'].iloc[row] = 'No_Game'
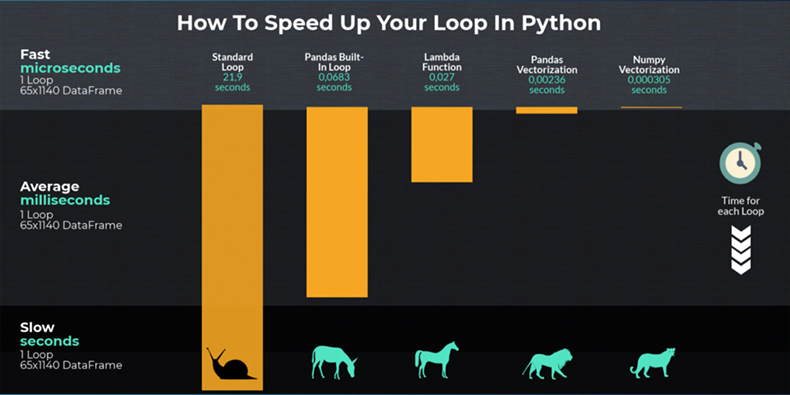
پس از آنکه نتیجه تمام بازیهای لیگ برتر را وارد دیتافریم کردیم، باید بررسی کنیم که آیا تیم موردنظر (در اینجا آرسنال) در کدام بازیها شرکت داشته و اگر شرکت داشته، آن بازی را در خانه بازی کرده یا در شهری دیگر مهمان بوده است. همانطور که مشاهده میکنید، این کد بسیار کند است و اجرای آن 20.7 ثانیه زمان میبرد. در ادامه، به شما میگوییم که چطور میتوان سرعت اجرای چنین کدی را بهبود بخشید.
افزایش 321 برابری سرعت کدها با استفاده از یک تابع تعبیهشده در pandas(): iterrows
در مثال اول ما حلقه را برای کل دیتافریم اجرا کردیم. تابع()iterrowsهر سطر از دیتافریم را به یک دنباله تبدیل میکند و دیتافریم را به صورت یک جفت شاخص-دنباله درنظر گرفته و تکرار میکند. بدین ترتیب، سرعت اجرای کدها از حالت حلقههای استاندارد بیشتر خواهد شد
def soc_iter(TEAM,home,away,ftr): #team, row['HomeTeam'], row['AwayTeam'], row['FTR'] if [((home == TEAM) & (ftr == 'D')) | ((away == TEAM) & (ftr == 'D'))]: result = 'Draw'https://XNET.com/%da%86%da%af%d9%88%d9%86%d9%87-%d8%b3%d8%b1%d8%b9%d8%aa-%d8%a7%d8%ac%d8%b1%d8%a7%db%8c-%d8%ad%d9%84%d9%82%d9%87-%d9%87%d8%a7%db%8c-pandas-%d8%b1%d8%a7-71803-%d8%a8%d8%b1%d8%a7%d8%a8%d8%b1-%d8%a7%d9%81/elif [((home == TEAM) & (ftr != 'D')) | ((away == TEAM) & (ftr != 'D'))]: result = 'No_Draw' else: result = 'No_Game' return result
اجرای این کد تنها 68 میلی ثانیه زمان میبرد که 321 برابر سریعتر از حلقههای استاندارد است. اما بسیاری توصیه میکنند که از این روش استفاده نشود، زیرا هم روشهای سریعتری وجود دارد و هم تابع()iterrowsدادههایی از نوع dtype را ذخیره نمیکند. یعنی اگر برای دادههای dtype موجود در دیتافریم از تابع()iterrowsاستفاده کنید، ممکن است نوع این دادهها تغییر کند و مشکلات زیادی برای کد شما ایجاد شود. البته برای ذخیره دادههای dtype میتوانید از تابع()itertuplesاستفاده کنید، اما در این مقاله وارد جزئیات این مسئله نمیشویم، زیرا هدف ما افزایش سرعت اجرا و کارایی کدهاست. برای مطالعه بیشتر در این خصوص میتوانید به اینلینکمراجعه نمایید.
[irp posts=”13793″]
با تابع ()apply سرعت اجرای کد را تا 811 برابر افزایش خواهد دهید
تابعapplyبه خودیخود سریعتر از روشهای قبلی نیست، اما یک مزیت نسبت به آنها دارد که به محتوایapplyبستگی دارد. اگر تابعapplyرا در محیط Cython پیاده کنید، سرعت آن به مراتب بیشتر خواهد بود (که در این مثال همین کار را میکنیم).
با بهکارگیری تابعLambdaمیتوانیم از روشapplyاستفاده کنیم. تنها کاری که لازم است انجام دهیم، تعیین یک مقدار برایaxisاست. در این مثال مقدار آن را برابر یک میگذاریم، زیرا میخواهیم عملیات در سطح ستونهای دیتافریم انجام گیرد.
سرعت اجرای این کد حتی از روش قبلی نیز سریعتر است و تنها 27 میلی ثانیه به طول میانجامد.
افزایش 9280 برابری سرعت اجرای کد با ایجاد بردار در pandas
در این روش به کمک بردارها میتوان کدی بسیار سریع و کارآمد نوشت. نکته اینجاست که باید حلقههای مرحلهای پایتون را که در مثال قبلی استفاده کردیم، کنار بگذاریم و از کدهای بهینهسازیشده در زبان C استفاده کنیم که در استفاده از حافظه سیستم بسیار کارآمدتر هستند. تنها کافی است تابع خود را اندکی اصلاح کنیم
def soc_iter(TEAM,home,away,ftr): df['Draws'] = 'No_Game'https://XNET.com/%da%86%da%af%d9%88%d9%86%d9%87-%d8%b3%d8%b1%d8%b9%d8%aa-%d8%a7%d8%ac%d8%b1%d8%a7%db%8c-%d8%ad%d9%84%d9%82%d9%87-%d9%87%d8%a7%db%8c-pandas-%d8%b1%d8%a7-71803-%d8%a8%d8%b1%d8%a7%d8%a8%d8%b1-%d8%a7%d9%81/df.loc[((home == TEAM) & (ftr == 'D')) | ((away == TEAM) & (ftr == 'D')), 'Draws'] = 'Draw' df.loc[((home == TEAM) & (ftr != 'D')) | ((away == TEAM) & (ftr != 'D')), 'Draws'] = 'No_Draw'
در این روش حتی به تعریف حلقه نیز نیازی نداریم. تنها کافی است محتویات تابع را تنظیم کنیم. حال میتوانیم دنبالههای pandas را مستقیماً به تابع بدهیم. بدین ترتیب سرعت تا حد زیادی افزایش پیدا میکند.
افزایش 71.803 برابری سرعت اجرای کد با ایجاد بردارهای numpy
در مثال قبل، دنبالههای pandas را به تابع دادیم با افزودن .values به کد، یک آرایه numpy خواهیم داشت.
آرایههای numpy به دلیل استفاده از حافظه محلی، سرعت بالایی دارند. اجرایی شدن این کد تنها 0.305 میلی ثانیه زمان میبرد و 71803 برابر سریعتر از حلقه استانداردی است که در مثال اول استفاده کردیم.
نتیجهگیری
اگر برای تحلیل دادهها از پایتون، pandas و numpy استفاده میکنید، همیشه راهی برای بهبود کدها پیش پای شما قرار دارد. ما عمل افزودن ستون جدید به دیتافریم را با هر 5 روش بالا امتحان کردیم و سرعت اجرای کد موردنظر در هر روش تفاوت قابلتوجهی با دیگری داشت
اکنون که چگونگی افزایش سرعت اجرای حلقه های pandas را فراگرفتید دو اصل زیر را هم بهخاطر بسپارید
1. اگر مطمئن هستید که به استفاده از یک حلقه نیاز دارید، بهتر است از روش apply استفاده کنید.
2. در غیر این صورت، ایجادبردارvectorهمواره اولویت دارد، زیرا سرعت آن بسیار بالاست.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.