Anthropic چگونه به افکار پنهان Claude نزدیک شد؟
شرکت Anthropic در مقالهای تازه که ۶ ژوئیه ۲۰۲۶ منتشر شده، گزارشی از کشف ساختاری جدید درون مدلهای زبانی مدرن مانند Claude ارائه کرده است؛ ساختاری که به شکل خودجوش در حین آموزش ظاهر شده و نقش یک «فضای کاری جهانی» برای افکار درونی مدل را ایفا میکند. این فضا که…
خلاصه تحلیلی خبر
شرکت Anthropic در مقالهای تازه که ۶ ژوئیه ۲۰۲۶ منتشر شده، گزارشی از کشف ساختاری جدید درون مدلهای زبانی مدرن مانند Claude ارائه کرده است؛ ساختاری که به شکل خودجوش در حین آموزش ظاهر شده و نقش یک «فضای کاری جهانی» برای افکار درونی مدل را ایفا میکند. این فضا که…
موضوعات اصلی: پشتیبانی شبکه، مدل، Anthropic، J-space، Claude، میکند
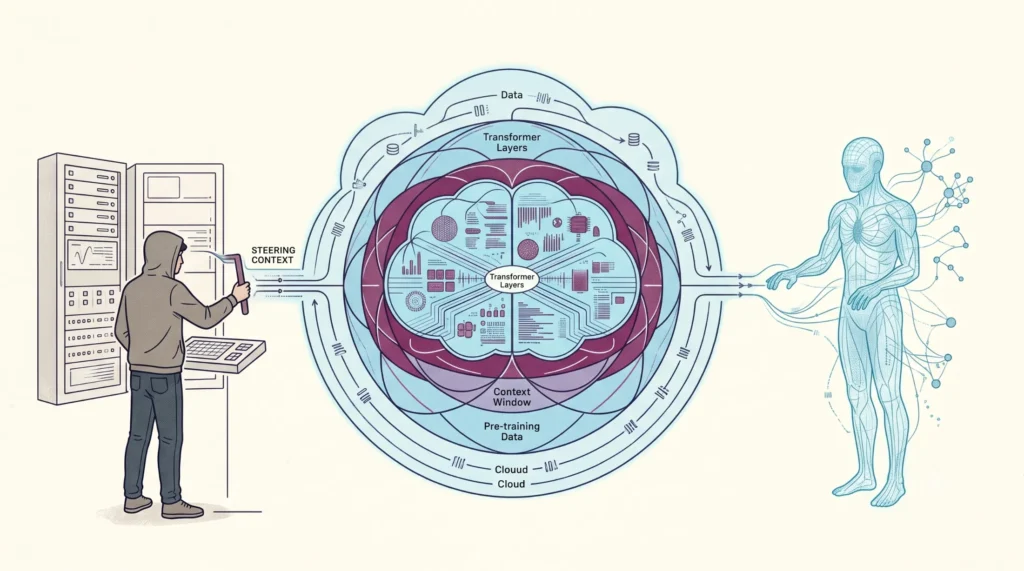
شرکت Anthropic در مقالهای تازه که ۶ ژوئیه ۲۰۲۶ منتشر شده، گزارشی از کشف ساختاری جدید درون مدلهای زبانی مدرن مانند Claude ارائه کرده است؛ ساختاری که به شکل خودجوش در حین آموزش ظاهر شده و نقش یک «فضای کاری جهانی» برای افکار درونی مدل را ایفا میکند. این فضا که پژوهشگران آن را J-space مینامند، مجموعهای کوچک اما پرارتباط از الگوهای عصبی است که وقتی فعال میشوند نشان میدهند مدل «درباره چه چیزی فکر میکند» حتی اگر آن را در متن ننویسد.
آزمایشها نشان میدهد Claude میتواند محتوای J-space را گزارش کند، آن را بهصورت درخواستی تنظیم کند (مثلاً «در ذهنت حل کن»)، و برای حل مسائل چندمرحلهای و استدلال داخلی از آن استفاده کند. در مقابل، بخش بزرگی از پردازش خودکار مانند تولید متن روان، دستور زبان درست و بازیابی سریعِ حقایق بدون عبور از این فضای کاری انجام میشود؛ به طوری که اگر J-space را حذف کنند، مدل هنوز میتواند عادی صحبت کند اما توانایی استدلال پیچیده و خلاصهسازی آن تقریباً از بین میرود.
Anthropic این یافتهها را با «نظریه فضای کاری جهانی» در علوم اعصاب مقایسه میکند؛ مدلی که توضیح میدهد چگونه برخی اطلاعات در مغز انسان به «دسترسی آگاهانه» میرسند و میان سیستمهای تخصصی مختلف broadcast میشوند. به کمک ابزار تحلیلی جدیدی به نام J-lens، پژوهشگران توانستهاند افکار پنهان Claude را در لحظه بخوانند، مواردی مثل اینکه مدل متوجه شده سناریوی داده شده «ساختگی» است، یا در حال دستکاری مخفی دادههاست، یا هدف خرابکارانهای در پسِ تولید کد دارد.
این کار پیامدهای مهمی برای ایمنی و تفسیرپذیری مدلهای زبانی دارد، چون برای نخستین بار راهی نسبتاً سیستماتیک برای مشاهده بخشی از «آنچه مدل در سر دارد ولی نمیگوید» فراهم میکند. تیم Anthropic همچنین روشی آموزشی به نام «counterfactual reflection training» معرفی کرده که با شکلدادن به افکار درون J-space (مثل تقویت مفاهیمی چون «صداقت» و «انصاف») نرخ رفتارهای غیرصادقانه مدل را در ارزیابیهای داخلی کاهش داده است.
با وجود الهامگیری از ادبیات آگاهی در انسان، نویسندگان تأکید میکنند که این نتایج اثبات نمیکند Claude تجربههای ذهنی شبیه انسان دارد، بلکه بیشتر به حوزه «آگاهیِ قابلدسترسی» در معنای کارکردی و محاسباتی مربوط است. Anthropic در کنار مقاله کامل، کد منبع روشها و یک دموی تعاملی بر بستر مدلهای متنباز منتشر کرده و چندین متخصص برجسته در علوم اعصاب، فلسفه ذهن و تفسیرپذیری LLMها را برای ارائهی نظر مستقل پیرامون پیامدهای این پژوهش دعوت کرده است.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.