OpenAI و برادکام از تراشه استنتاج بهینهشده برای مدلهای زبانی بزرگ رونمایی کردند
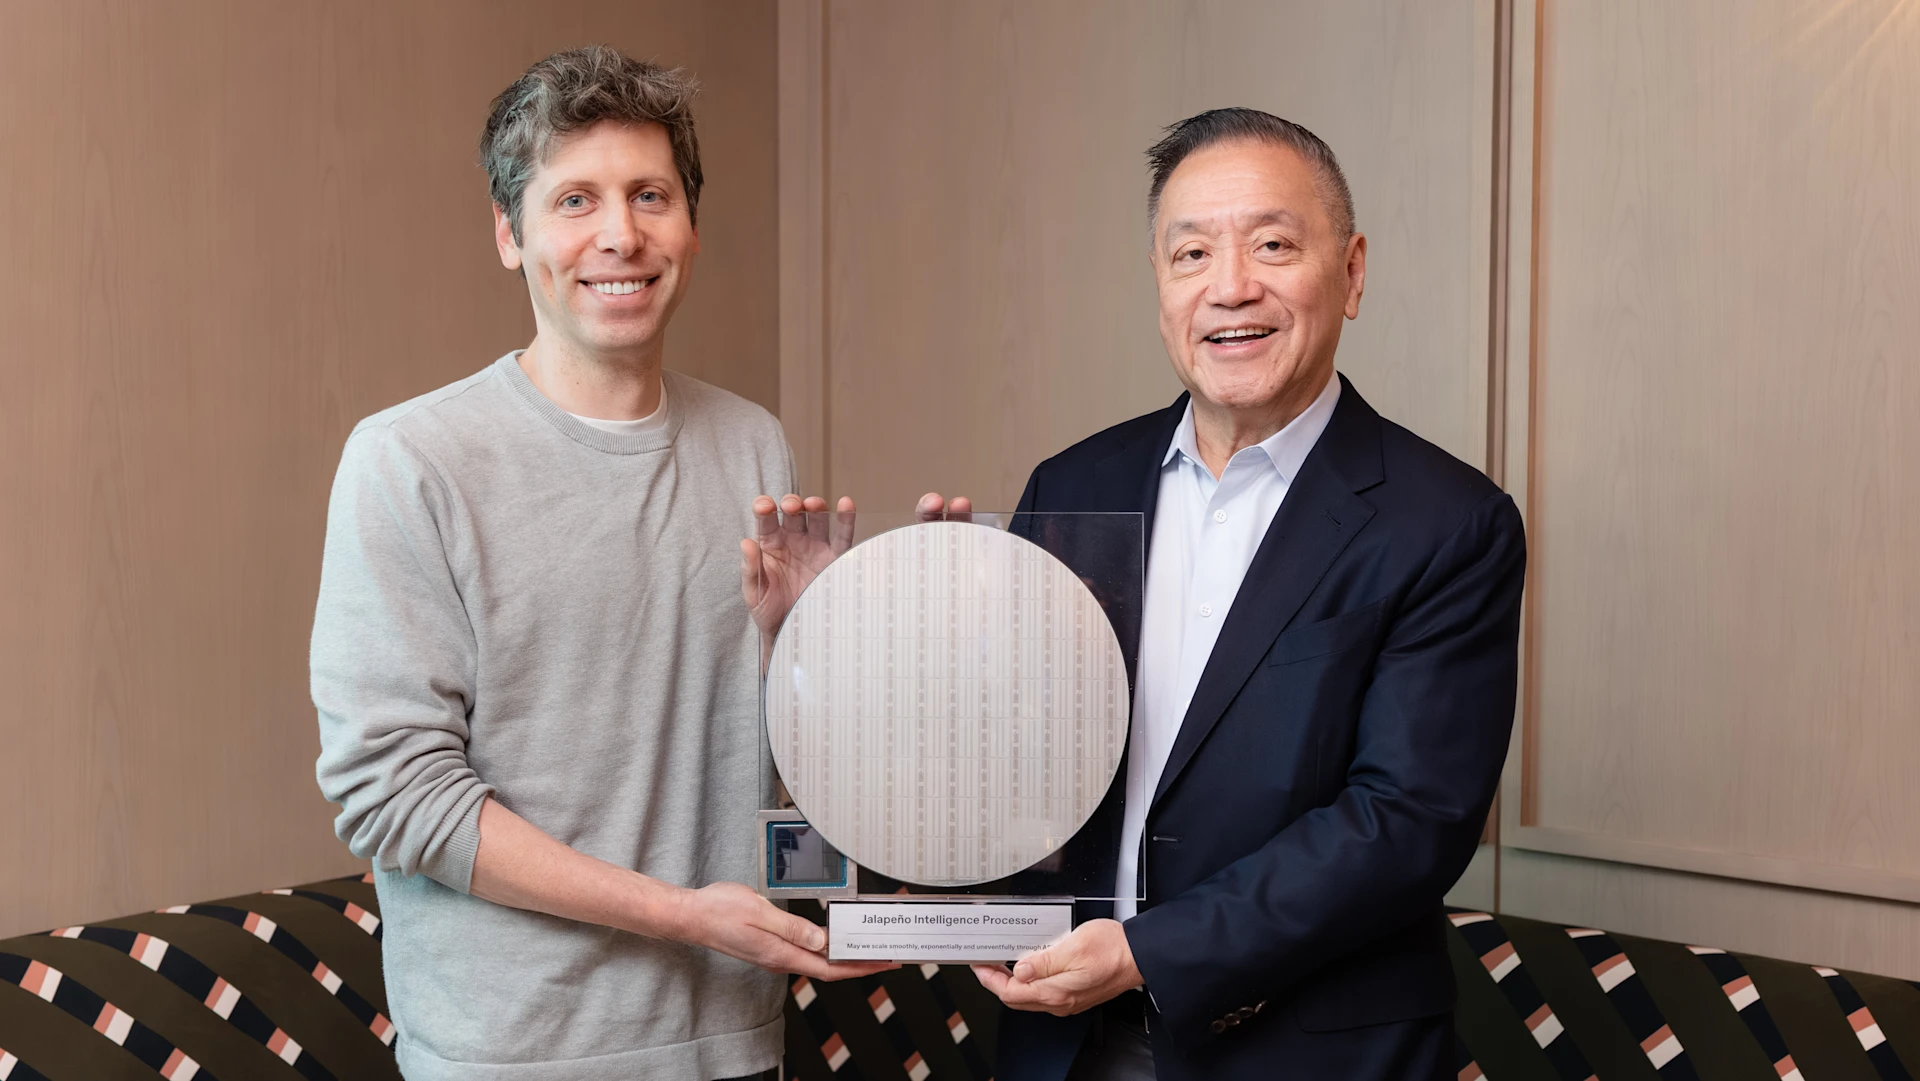
OpenAI و برادکام از نخستین «پردازنده هوشمندی» (Intelligence Processor) اختصاصی OpenAI به نام Jalapeño رونمایی کردند؛ تراشهای که بر اساس چشمانداز OpenAI برای آینده استنتاج مدلهای زبانی بزرگ طراحی شده است. این تراشه، نخستین شتابدهنده هوش مصنوعی در یک پلتفرم…
خلاصه تحلیلی خبر
OpenAI و برادکام از نخستین «پردازنده هوشمندی» (Intelligence Processor) اختصاصی OpenAI به نام Jalapeño رونمایی کردند؛ تراشهای که بر اساس چشمانداز OpenAI برای آینده استنتاج مدلهای زبانی بزرگ طراحی شده است. این تراشه، نخستین شتابدهنده هوش مصنوعی در یک پلتفرم…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، مدلهای، OpenAI، مصنوعی، هوش
OpenAI و برادکام از نخستین «پردازنده هوشمندی» (Intelligence Processor) اختصاصی OpenAI به نام Jalapeño رونمایی کردند؛ تراشهای که بر اساس چشمانداز OpenAI برای آینده استنتاج مدلهای زبانی بزرگ طراحی شده است.
این تراشه، نخستین شتابدهنده هوش مصنوعی در یک پلتفرم محاسباتی چندنسلی است که دو شرکت بهصورت مشترک در حال توسعه آن هستند تا هوش مصنوعی پیشرفته را سریعتر، قابلاعتمادتر و در دسترس افراد بیشتری قرار دهند.
Jalapeño چه وظیفهای دارد؟
OpenAI این تراشه را از ابتدا و بر پایه درک عمیق خود از اصول بنیادین مدلهای زبانی بزرگ طراحی کرده است؛ درکی که بر اساس نقشه راه مدلها، کرنلها، سامانههای خدمترسانی (Serving Systems) و نیازهای محصولات این شرکت شکل گرفته است. در این مسیر، برادکام و Celestica بهعنوان شرکای OpenAI با پیادهسازی تراشه، طراحی برد، یکپارچهسازی رکها، شبکهسازی با کارایی بالا و توسعه سامانههای تولید در مقیاس، این پلتفرم را به مرحله صنعتی رساندهاند. Jalapeño با انعطافپذیری لازم برای پشتیبانی از تمامی مدلهای زبانی بزرگ طراحی شده و نیازهای استنتاج مدلهای هوش مصنوعی کنونی و آینده را بر اساس بینشهای OpenAI پوشش میدهد. نمونههای مهندسی این تراشه هماکنون در آزمایشگاه و با فرکانس و توان هدف تولید، در حال اجرای بارهای کاری یادگیری ماشین از جمله GPT 5.3 Codex Spark هستند.
اگرچه OpenAI هنوز در حال ارزیابی عملکرد نهایی این تراشه است، اما آزمایشهای اولیه نشان میدهد Jalapeño از نظر عملکرد بهازای هر وات، به طور محسوسی بهتر از پیشرفتهترین شتابدهندههای موجود عمل خواهد کرد. گزارش فنی مفصلی درباره عملکرد این تراشه در ماههای آینده منتشر میشود. معماری Jalapeño با کاهش جابهجایی دادهها و ایجاد توازن میان منابع پردازشی، حافظه و شبکه، نرخ بهرهبرداری واقعی از سختافزار را به سطحی بسیار نزدیک به حداکثر عملکرد نظری میرساند. فناوریهای پیادهسازی سیلیکون و شبکهسازی برادکام از جمله تراشههای شبکه Tomahawk نیز امکان تولید این پلتفرم در مقیاس وسیع را فراهم میکنند.
طراحیشده برای تبدیلشدن به بهترین پلتفرم استنتاج مدلهای زبانی بزرگ
Jalapeño یک طراحی کاملاً جدید برای استنتاج مدلهای زبانی بزرگ مدرن است و برخلاف بسیاری از شتابدهندهها، نسخهای سازگارشده از معماریهای عمومی مربوط به بارهای کاری قدیمی هوش مصنوعی محسوب نمیشود. این تراشه بر اساس تجربه عملیاتی OpenAI در اجرای روزانه ChatGPT ،Codex ،API و محصولات عاملمحور آینده طراحی شده و درعینحال برای پاسخگویی به نیازهای مدلهای زبانی بزرگ کنونی و آینده در سراسر صنعت نیز بهینه شده است. هدف این پروژه، ترکیب توان پردازشی و ظرفیت گذردهی شتابدهندههای پیشرفته امروزی با تأخیری نزدیک به سریعترین سامانههای تخصصی استنتاج است؛ ویژگیای که Jalapeño را به گزینهای مناسب برای ارائه محصولات تعاملی مبتنی بر مدلهای زبانی بزرگ در مقیاس گسترده تبدیل میکند.
این همان مزیت رویکرد فولاستک است. OpenAI تنها به توسعه مدلهای پیشرو یا ساخت محصولات بر پایه آنها اکتفا نمیکند، بلکه زیرساختی را نیز که این مدلها بر آن اجرا میشوند طراحی میکند؛ از معماری تراشه، کرنلها، سامانههای حافظه، شبکه و زمانبندی گرفته تا سامانههای استقرار و تجربه محصول. ازآنجاکه OpenAI بر تمام لایههای این پشته فناوری تسلط دارد، میتواند هر لایه را در راستای یک هدف مشترک بهینهسازی کند؛ سریعتر، قابلاعتمادتر و مقرونبهصرفهتر کردن مدلهای خود برای کاربران.
Jalapeño چرخه پیشرفت OpenAI را نیز تقویت میکند. زیرساخت بهتر، بهرهوری محاسباتی را افزایش میدهد، بهرهوری بیشتر، آموزش و سروینگ مدلها را بهبود میبخشد و در نهایت به توسعه مدلهای هوش مصنوعی توانمندتر منجر میشود. مدلهای بهتر نیز به محصولات بهتری برای کاربران، توسعهدهندگان و کسبوکارها تبدیل میشوند. محصولات بهتر، استفاده بیشتر، مشتریان بیشتر و درآمد بالاتر را به همراه دارند و این درآمد دوباره صرف توسعه نسل بعدی زیرساخت میشود. در بلندمدت، این چرخه باعث میشود هوش مصنوعی برای همه، توانمندتر، قابلاعتمادتر و کمهزینهتر شود.
تکمیل Tape-out در ۹ ماه؛ با شتابدهی مدلهای OpenAI
Jalapeño از مرحله طراحی اولیه تا رسیدن به مرحله Tape-out تولید، تنها در مدت ۹ ماه توسعه یافته است و برنامه توسعه این شتابدهنده اختصاصی هوش مصنوعی، به باور OpenAI سریعترین چرخه توسعه یک مدار مجتمع اختصاصی (ASIC) در تاریخ نیمهرساناهای پیشرفته با کارایی بالا محسوب میشود. این سرعت حاصل توسعه همزمان نرمافزار و سختافزار توسط تیمهای مهندسی OpenAI، تخصص برادکام در پیادهسازی سیلیکون و همچنین استفاده از مدلهای OpenAI برای تسریع بخشی از فرایندهای طراحی و بهینهسازی بوده است.
بهاینترتیب، همان مدلهایی که امروز در اختیار کاربران قرار دارند، به بهبود زیرساخت اجرای نسلهای آینده مدلها نیز کمک میکنند. اگر هوش مصنوعی بتواند مهندسان را در طراحی سریعتر و بهتر تراشهها یاری دهد، هزینه توان محاسباتی در سراسر صنعت کاهش خواهد یافت و دسترسی به هوش مصنوعی پیشرفته بیشازپیش دموکراتیزه میشود.
توسعه یک پلتفرم چندنسلی با همکاری شرکا
Jalapeño نخستین گام در مسیر توسعه یک پلتفرم محاسباتی چندنسلی است که قرار است نخستین استقرار آن تا پایان سال ۲۰۲۶ انجام شود و در سالهای بعد نیز گسترش یابد. این پلتفرم، شتابدهندههای طراحیشده توسط OpenAI را با فناوریهای پیادهسازی سیلیکون، شبکه و اتصال برادکام و همچنین تخصص سلستیکا در طراحی برد، رک و سامانههای سختافزاری ترکیب میکند.
فراهمکردن دسترسی گستردهتر به هوش مصنوعی پیشرفته
هدف نهایی این پروژه ساده است: استنتاج، نقطهای است که هوش مصنوعی به زندگی مردم وارد میشود. هر بهبود در هزینه، سرعت یا قابلیت اطمینان، میتواند به شکل پاسخ سریعتر ChatGPT، انجام وظایف پیچیدهتر در Codex با زمان انتظار کمتر، کاهش هزینه توسعه محصولات مبتنی بر API یا دسترسی پایدارتر به سرویسها در زمان اوج تقاضا نمایان شود.
دموکراتیزه کردن هوش مصنوعی به این معناست که مدلهای پیشرفته، بهاندازهای در دسترس، قابلاعتماد و مقرونبهصرفه باشند که افراد بیشتری بتوانند هر روز از آنها استفاده کنند. Jalapeño به OpenAI کمک میکند تا بخش بیشتری از زیرساخت خود را به هوشمندی کاربردی برای دانشجویان، توسعهدهندگان، کسبوکارهای کوچک، پژوهشگران، سازمانها و هر فردی که در پی یادگیری، خلق ایده یا حل مسائل دشوار است، تبدیل کند.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.