انویدیا از مدل هوش مصنوعی جدید خود برای تبدیل صدا به متن رونمایی کرد
انویدیا از مدل هوش مصنوعی جدیدی با نام Nemotron 3.5 Transcribe رونمایی کرده است که میتواند فایلهای صوتی را به متن تبدیل کند، زبان گفتار را تشخیص دهد، صحبتهای افراد مختلف را از یکدیگر تفکیک کند و حتی محتوای ضبطشده را ترجمه کند. این مدل بهصورت رایگان در دست…
خلاصه تحلیلی خبر
انویدیا از مدل هوش مصنوعی جدیدی با نام Nemotron 3.5 Transcribe رونمایی کرده است که میتواند فایلهای صوتی را به متن تبدیل کند، زبان گفتار را تشخیص دهد، صحبتهای افراد مختلف را از یکدیگر تفکیک کند و حتی محتوای ضبطشده را ترجمه کند. این مدل بهصورت رایگان در دست…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، مدل، کند، صوتی، توسعهدهندگان
انویدیا از مدل هوش مصنوعی جدیدی با نام Nemotron 3.5 Transcribe رونمایی کرده است که میتواند فایلهای صوتی را به متن تبدیل کند، زبان گفتار را تشخیص دهد، صحبتهای افراد مختلف را از یکدیگر تفکیک کند و حتی محتوای ضبطشده را ترجمه کند.
این مدل بهصورت رایگان در دسترس توسعهدهندگان قرار گرفته و از ۴۰ زبان پشتیبانی میکند. انویدیا همزمان با انتشار این مدل، نسخه دوم مجموعهداده متنباز Granary را نیز معرفی کرد؛ این مجموعهداده به توسعهدهندگان اجازه میدهد مدلهای پردازش گفتار را آموزش دهند و برای کاربردهای تخصصی، از جمله پیادهسازی جلسات کاری و تهیه متن مکالمات پزشکی، بهینه کنند.
این مدل که با نام Nemotron 3.5 Transcribe شناخته میشود، میتواند فایلهای صوتی را به متن تبدیل کند، زبان گفتار را تشخیص دهد و صحبتهای افراد مختلف را از یکدیگر تفکیک کند. این ابزار از وزنهای باز بهره میبرد و انویدیا آن را بهصورت رایگان در اختیار توسعهدهندگان قرار داده است.
مدلی برای تبدیل صدا به متن و ترجمه
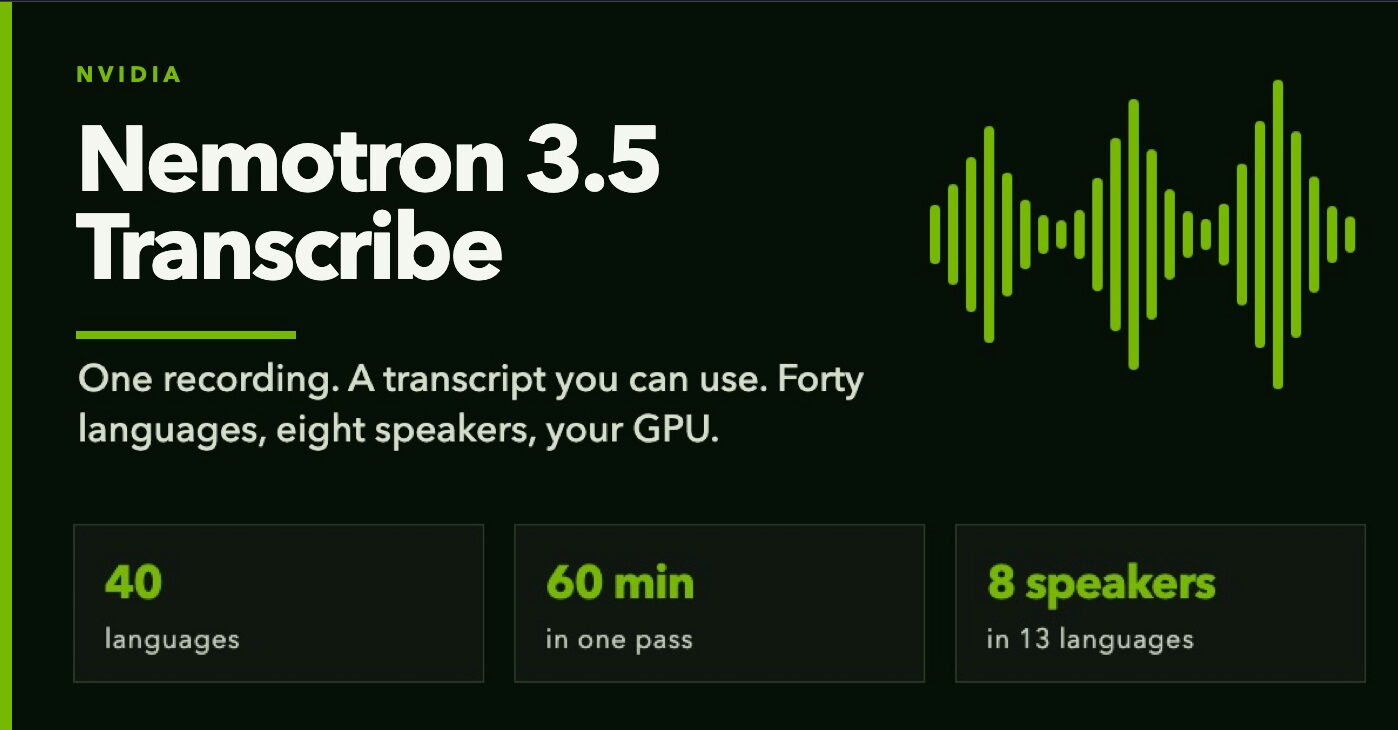
یکی از ویژگیهای مهم Nemotron 3.5 Transcribe، پشتیبانی از ۴۰ زبان و توانایی ترجمه گفتار میان ۳۱ زبان و انگلیسی است. این مدل میتواند فایلهای صوتی ضبطشده با حداکثر یک ساعت زمان را پردازش کند و صدای حداکثر هشت گوینده را از یکدیگر تشخیص دهد. همچنین، در صورت نیاز، زمان دقیق بیان هر کلمه را در فایل صوتی مشخص میکند.
نکته مهم اینجاست که توسعهدهندگان برای انجام این وظایف به چند مدل هوش مصنوعی مجزا احتیاج ندارند. آنها میتوانند با استفاده از دستورهای متنی، از یک مدل برای پیادهسازی مکالمات، شناسایی گویندگان، ترجمه و استخراج اطلاعات از فایل صوتی کمک بگیرند.
برای مثال، این مدل میتواند محتوای یک جلسه کاری را به متن تبدیل کند، تصمیمهای گرفتهشده در جریان جلسه را استخراج کند یا مکالمه ضبطشده را به انگلیسی ترجمه کند. همچنین، توسعهدهندگان میتوانند اصطلاحات تخصصی یک حوزه را در اختیار مدل قرار دهند تا دقت آن هنگام پردازش مکالمات پزشکی، مالی و خدمات مشتریان افزایش یابد.
عملکرد قدرتمند با وجود تعداد پارامترهای بالا
بر اساس اطلاعات منتشرشده از سوی انویدیا، Nemotron 3.5 Transcribe در مجموع ۳۰ میلیارد پارامتر دارد، اما هنگام اجرا حدود ۴.۳ میلیارد پارامتر فعال است؛ این ساختار به مدل اجازه میدهد وظایف پیچیده پردازش گفتار را انجام دهد، بدون آنکه تمام پارامترهایش در هر مرحله فعال باشند.
انویدیا همچنین اعلام کرده است که این مدل در بنچمارکهای Open ASR عملکرد بسیار خوبی دارد و در میان مدلهای دارای وزن باز، رتبه نخست را در ارزیابیهای انگلیسی و چندزبانه کسب کرده است. البته این نتایج به مجموعه آزمونهای مشخص مربوط میشوند و لزوماً به معنای برتری مدل در تمام شرایط واقعی نیستند.
مجموعهداده جدید برای توسعه مدلهای گفتاری
همزمان با انتشار مدل جدید در ۶ آبان ۱۴۰۵ (۲۸ اکتبر ۲۰۲۶)، انویدیا نسخه دوم مجموعهداده متنباز Granary را نیز معرفی کرد. این مجموعهداده عمومی، اطلاعات صوتی و متنی مربوط به بیش از ۴۶۳ هزار ساعت محتوا را در ۴۸ زبان پوشش میدهد و میتواند برای آموزش و بهینهسازی مدلهای پردازش گفتار استفاده شود.
با این حال، Nemotron 3.5 Transcribe فعلاً برای پردازش فایلهای صوتی ضبطشده طراحی شده و از رونویسی زنده پشتیبانی نمیکند. توسعهدهندگان میتوانند وزنهای مدل و ابزارهای موردنیاز برای شخصیسازی آن را دریافت کنند و با توجه به کاربرد موردنظرشان، نسخههای اختصاصی بسازند.
برای بررسی جزئیات فنی و دریافت مدل، میتوانید به صفحه رسمی مدل Nemotron 3.5 Transcribe مراجعه کنید.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.