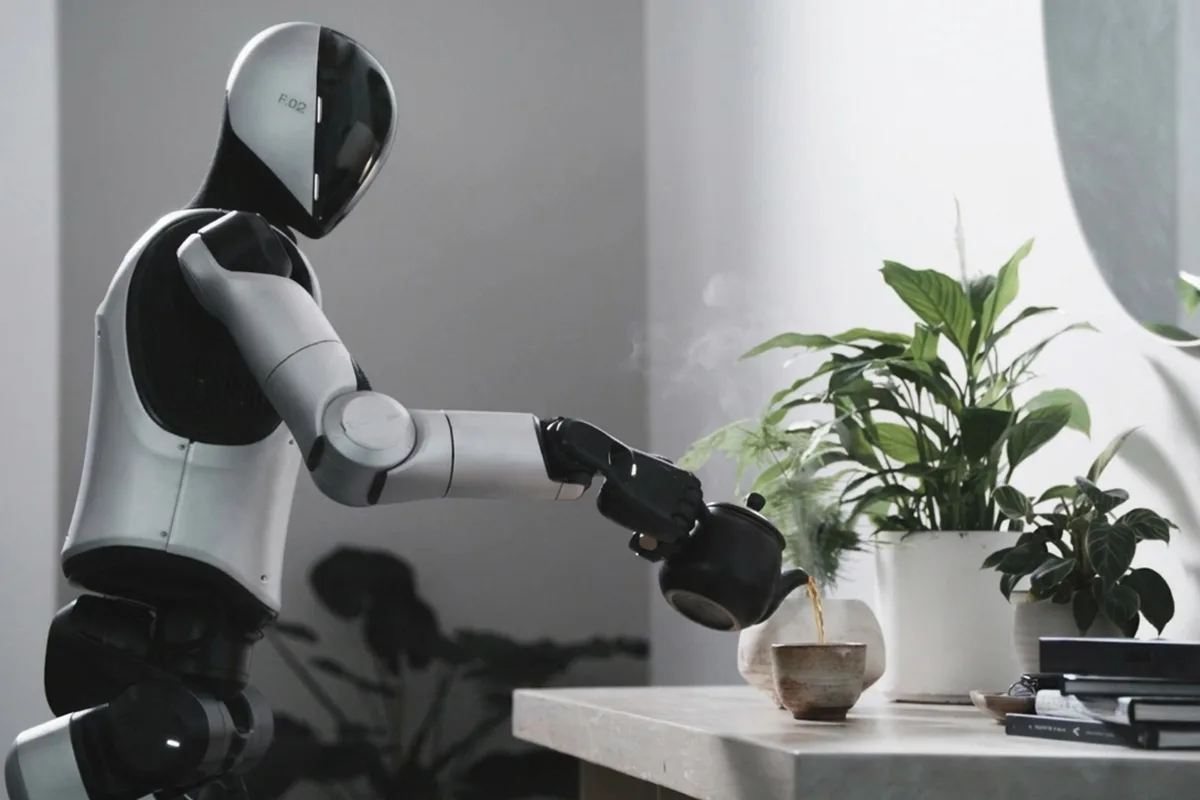
چرا هوش مصنوعی هنوز نمیتواند یک فنجان چای دستمان بدهد؟
چند سالی است هوش مصنوعی یاد گرفته مثل یک منشی خوشسخن، برایمان متن بنویسد، شعر بگوید و مفاهیم فلسفی پیچیده را در سه خط خلاصه کند. اما کافی است از همین نابغه پرحرف بخواهید یک گلدان شیشهای نازک را از روی میز آشپزخانه بردارد و روی طاقچه بگذارد. او دقیقترین مراح…
خلاصه تحلیلی خبر
چند سالی است هوش مصنوعی یاد گرفته مثل یک منشی خوشسخن، برایمان متن بنویسد، شعر بگوید و مفاهیم فلسفی پیچیده را در سه خط خلاصه کند. اما کافی است از همین نابغه پرحرف بخواهید یک گلدان شیشهای نازک را از روی میز آشپزخانه بردارد و روی طاقچه بگذارد. او دقیقترین مراح…
موضوعات اصلی: پشتیبانی شبکه، هوش مصنوعی، میکند، مدل، هوش، مصنوعی
چند سالی است هوش مصنوعی یاد گرفته مثل یک منشی خوشسخن، برایمان متن بنویسد، شعر بگوید و مفاهیم فلسفی پیچیده را در سه خط خلاصه کند. اما کافی است از همین نابغه پرحرف بخواهید یک گلدان شیشهای نازک را از روی میز آشپزخانه بردارد و روی طاقچه بگذارد. او دقیقترین مراحل را روی مانیتور تحویلتان میدهد اما پای عمل که برسد، دست مکانیکی ربات با اولین فشار گلدان را خرد میکند.
مشکل اینجاست که چتباتها فقط توصیف دنیا با کلمات را یاد گرفتهاند، بدون اینکه کوچکترین درکی از سنگینی سنگ، لیزی روغن یا شکنندگی بلور داشته باشند. برای پر کردن این شکاف عمیق، گوگل، انویدیا و متا وارد رقابت تازهای برای توسعه «مدلهای جهانی» (World Models) شدهاند؛ سیستمی که قرار است پای ماشینها را در عمل به دنیای ما باز کند.
بنبست کلمات؛ چرا چتباتها دنیای واقعی را نمیفهمند؟
مدلهای زبانی بزرگ مثل ChatGPT با بلعیدن میلیاردها صفحه متن، در نوشتن و کدنویسی شاهکار میکنند؛ اما منطق پشت پرده همه آنها حدس زدن کلمه بعدی در یک جمله است و درکی از فیزیک جهان ندارند.
یک کودک دو ساله بدون اینکه بداند جاذبه چیست، بارها افتادن اسباببازیاش را روی فرش تماشا میکند. دستش را به لبه میز میگیرد، بالا رفتن را تجربه میکند و خیلی زود متوجه میشود که اگر توپ را هل بدهد قل میخورد. این کودک در مغز خود یک مدل ذهنی از جهان میسازد؛ دانشی شهودی و عمیق که با میلیونها صفحه خواندن متن به دست نمیآید، بلکه حاصل نگاه کردن، حرکت و لمس مواد است.
«یان لکان» (Yann LeCun)، از پدران «یادگیری عمیق»، سالهاست که میگوید باد کردن مدلهای زبانی با خواندن متون بیشتر به آنها، هرگز ما را به هوش مصنوعی در سطح انسان نمیرساند. از نظر وی هوش واقعی زمانی شکل میگیرد که ماشین بتواند از دنیای فیزیکی یاد بگیرد، اتفاقات بعدی را پیشبینی کند و بر اساس پیشبینیها دست به عمل بزند.
شبیهسازی ذهنی؛ کاری که انسان هر ثانیه انجام میدهد
مغز ما به شکل مداوم در حال شبیهسازی عواقب کارهایمان قبل از انجام دادن آنهاست. وقتی میخواهید از خیابانی شلوغ رد شوید، در لحظه سرعت ماشینهایی که نزدیک میشوند را تخمین میزنید، فاصله خودتان تا جدول سمت مقابل را میسنجید و در ذهنتان یک شبیهسازی سریع اجرا میکنید: «اگر الان با این سرعت بدوم، قبل از رسیدن آن پژو ۴۰۵ از خط رد شدهام، اما اگر موتورسیکلت کنارش تغییر مسیر بدهد، به مشکل میخورم.»
همین مکانیزم زمانی که دستتان را برای برداشتن یک لیوان آب دراز میکنید، یا وقتی میخواهید چند جعبه را روی هم بچینید، در مغز شما فعال است. انسان با تکیه بر تجربه، حافظه و مشاهده، رفتار اشیا و محیط اطرافشان را پیشبینی میکنند.
متخصصان تلاش میکنند همین قدرت پیشبینی و شبیهسازی درونی را به ماشینها بدهند.
دو فلسفه متفاوت: دعوای علمی لکان و هاسابیس
در خط مقدم این فناوری، دو چهره سرشناس هوش مصنوعی با دو دیدگاه فنی متفاوت ایستادهاند: یان لکان و دمیس هاسابیس (مدیرعامل گوگل دیپمایند و برنده نوبل شیمی). هر دو قبول دارند که هوش مصنوعی باید فیزیک دنیا را بفهمد، اما مسیرشان برای رسیدن به این هدف فرق میکند.
دیدگاه یان لکان: حذف جزئیات اضافه
حرف حساب لکان ساده است. او میگوید دنیای فیزیکی پر از جزئیات غیرقابل پیشبینی و بیفایده برای تصمیمگیری است. وقتی یک گربه از روی دیوار میپرد، مهم نیست تارهای مویش چطور در هوا تکان میخورند یا انعکاس برگ درختان در چشمش چه شکلی میشود؛ آنچه تعیینکننده است، جهت پریدن، شتاب و نقطه فرود آمدن اوست.
اگر هوش مصنوعی بخواهد تکتک پیکسلهای ویدیوی آینده را تولید کند، کل توان پردازش تراشههای گرانقیمت را صرف جزئیاتی میکند که در تصمیمگیری اهمیتی ندارند. روش پیشنهادی لکان معماری JEPA است که در آن هوش مصنوعی بهجای بازسازی تصویر آینده، ابتدا اطلاعات تصویر را به یک بازنمایی فشرده و ریاضی تبدیل میکند؛ فضایی که در آن ویژگیهای مهم صحنه مثل موقعیت اشیا و روابط میان آنها حفظ میشوند. سپس یک شبکه پیشبینیکننده آینده محیط را حدس میزند. به این ترتیب مدل ظرفیت پردازشی خود را روی اطلاعاتی متمرکز میکند که برای فهم محیط و تصمیمگیری اهمیت دارند، نه اینکه نقاشی بکشد.
دیدگاه دمیس هاسابیس: یادگیری فیزیک از دل تولید ویدیو
در سوی دیگر میدان، دمیس هاسابیس با عینکی متفاوت به ماجرا نگاه میکند. او باور دارد تماشای میلیاردها ساعت ویدیو از رفتار دنیا از ریختن چای در لیوان گرفته تا برخورد موج به صخره به مدلها یاد میدهد که سازوکار دنیا و رابطه علت و معلولی چیست.
هاسابیس معتقد است وقتی یک مدل تولید تصویر یاد میگیرد جریان روان آب را طبیعی بسازد، تا حدی به فیزیک شهودی ماده دست یافته است. البته خودش قبول دارد که ساختن یک ویدیوی زیبا و واقعی، به این معنی نیست که هوش مصنوعی واقعاً قوانین مکانیک و ترمودینامیک را فهمیده، اما این مسیر را گامی کلیدی برای رسیدن به هوش مصنوعی جامع (AGI) میداند.
پروژههای بزرگی از گوگل، انویدیا و متا با پیادهسازی این راهکارها به دنبال دستیابی به مدل جهانی هستند.
چهار پروژه پیشتاز: بازی، پردازش و عمل مکانیکی
غولهای فناوری هر کدام از زاویه کسبوکار و تخصص خودشان به سراغ ساخت مدلهای جهانی رفتهاند. بیایید ببینیم هر کدام دقیقاً چه چیزی ساختهاند.
۱. پروژه Genie 4 گوگل دیپمایند؛ ساختن دنیاهایی که میشود در آنها قدم زد
گوگل دیپمایند در پروژه Genie به جای ساختن ویدیوهای ثابتی که شما فقط تماشاگرش هستید، روی ساختن محیطهای تعاملی تمرکز کرده؛ چیزی شبیه به یک بازی ویدیویی که در لحظه توسط هوش مصنوعی خلق میشود. شما یک جنگل را توصیف میکنید، وارد آن میشوید، به سمت رودخانه قدم میزنید، دستور میدهید هوا بارانی شود یا یک تخته سنگ جلوی مسیرتان قرار بگیرد، و مدل در همان لحظه ادامه صحنه و واکنش محیط را میسازد.
گوگل چند هفته قبل نسخه جدید این سیستم یعنیGenie 4 را معرفی کرد. این نسخه نهتنها محیطهای بسیار واقعیتری را بهصورت زنده میسازد، بلکه صداهای محیطی، موسیقی و دیالوگهای تعاملی را هم تولید میکند و کاربر میتواند حین گشتوگذار در محیط، با دستورات متنی ساده، صحنه را تغییر دهد.
برگ برنده Genie 4 اتصال آن به خانواده مدلهای جمینای (بهویژه Omni) است که به شبیهسازیها کمک میکند تا ظاهر و رفتاری منطبق با دنیای واقعی داشته باشند و منطق صحنهها به هم نریزد.
بزرگترین کاربرد این مدل آموزش رباتهاست. Genie 4 یک زمین تمرین مجازی بیپایان میسازد تا رباتها هزاران بار در آن اشتباه کنند، با موانع غیرمنتظره روبهرو شوند و کار با اشیا ناشناس را یاد بگیرند، بدون اینکه حتی یک پیچ در دنیای واقعی آسیب ببیند.
۲. پروژه Cosmos 3 انویدیا؛ پیریزی پایههای هوش فیزیکی
کازموس ۳ پلتفرمی جامع برای نزدیک کردن سه مرحله درک محیط، پیشبینی اتفاقات بعدی و اقدام مناسب است. معماری این مدل دو بخش اصلی دارد
- شبکه استدلالگر:اطلاعات تصویری، متنی، صوتی و حرکتی را تحلیل میکند.
- بخش مولد مبتنی بر دیفیوژن: خروجیهایی مانند تصویر، ویدیو و مسیرهای حرکتی تولید میکند.
انویدیا دو اندازه از این مدل را معرفی کرده: نسخه نانو با ۱۶ میلیارد پارامتر برای اجرا روی ورکاستیشن و نسخه سوپر با ۶۴ میلیارد پارامتر برای زیرساختهای دیتاسنتری.
۳. پروژه V-JEPA 2 متا؛ یادگیری قوانین بدون بازی با رنگها
راهکار متا بر پایه نظریههای یان لکان استوار است که میگوید برای فهمیدن قوانین فیزیک، نیازی به بازسازی تکتک پیکسلهای تصویر نیست. مدل V-JEPA 2 با تماشای بیش از یک میلیون ساعت ویدیوی عمومی آموزش دیده، بدون اینکه انسانی پای مانیتور بنشیند و برایش برچسب بزند که «این یک صندلی است» یا «این یک گربه است». مدل با خودآموزی یاد گرفته که حرکت اشیا در فضا از چه اصولی پیروی میکند.
بخش شگفتانگیز این پروژه نسخه ویژهای به نام V-JEPA 2-AC است. محققان به این مدل ۶۲ ساعت ویدیوی ضبطشده از حرکات بازوی مکانیکی ربات «فرانکا» نشان دادند. نتیجه خیرهکننده بود: این بازوی مکانیکی توانست در آزمایشگاهی که قبلاً آنها را ندیده بود، با نرخ موفقیت ۶۵ تا ۸۰ درصدی وسایل مختلف را بردارد، جابهجا کند و روی سطوح بگذارد؛ بدون نیاز به اینکه مهندسان برای تکتک اشیای جدید برنامهنویسی کنند یا داده اختصاصی به آن بدهند.
روش کار ربات هم جالب است. محققان تصویری از وضعیت مطلوب را به سیستم میدهند. مدل ابتدا وضعیت فعلی و تصویر هدف را به بازنماییهای ریاضی تبدیل میکند؛ سپس پیامد مجموعهای از حرکتهای احتمالی را در فضای پیشبینی خود شبیهسازی میکند و حرکتی را انتخاب میکند که به هدف نزدیکتر است.
۴. پروژه Atlas از شرکت World Labs
این شرکت را« فیفی لی»، از برجستهترین دانشمندان بینایی کامپیوتر تأسیس کرده. اطلس متون، تصاویر و فیلمها را تبدیل به یک فضای هندسی سهبعدی باثبات میکند. هدفش آوردن «هوش فضایی» به ماشینهاست؛ همان درکی که یک معمار هنگام نگاه به یک اتاق دارد تا متوجه شود کدام ستون وزن را تحمل میکند و کدام دیوار صرفاً تیغه جداکننده است.
چرا ورود مدلهای جهان، صنعت رباتیک را زیر و رو میکند؟
رباتهای فعلی که در خطوط تولید (مثل بازوهای جوشکاری یا رنگپاشی) میبینیم، در محیطهای صددرصد کنترلشده کار میکنند. جای قطعه با دقت میلیمتری مشخص است و هیچ عامل غافلگیرکنندهای وجود ندارد.
اگر بخواهیم رباتی بسازیم که در یک خانه، بیمارستان یا انبار شلوغ کار کند، همه چیز عوض میشود. در خانه لیوان ممکن است پشت کتری قایم شده باشد، صندلی نسبت به دیروز جابهجا شده باشد یا یک کودک ناگهان جلوی پای ربات بدود.
مدلهای جهانی در سه بخش کلیدی میتوانند این قفل را باز کنند
۱. کاهش چشمگیر هزینههای آموزش: به جای اینکه صدها ربات فیزیکی را در دنیای واقعی به کار بگیریم تا با آزمون و خطا و شکستن وسایل یاد بگیرند چطور اشیا مختلف را بلند کنند، رباتها میتوانند میلیونها ساعت در محیطهای شبیهسازیشده تمرین کنند و بعد وارد دنیای واقعی شوند.
۲. تصمیمگیری منعطف در لحظه: ربات حمل بار دیگر با دیدن یک مانع غیرمنتظره قفل نمیکند؛ پیشبینی درونی به مدل میگوید: «اگر این بسته را کمی به چپ هل بدهی، کارتن بالایی سر میخورد و میافتد. پس اول جعبه بالا را بردار، بعد راهت را باز کن.»
۳. آمادگی برای اتفاقات نادر و خطرناک: در رانندگی خودران موقعیتهای عجیب و خطرناک (مثل پریدن عابری به وسط خیابان در شب بارانی) هر روز اتفاق نمیافتند که خودرو از آنها یاد بگیرد. مدلهای جهانی به مهندسان اجازه میدهند هزاران مورد از این سناریوهای نادر را شبیهسازی و سیستم را قبل از ورود به خیابانهای واقعی آزمایش کنند.
از کجا بفهمیم هوش مصنوعی واقعاً فیزیک را فهمیده است؟
به مهمترین سوال و پاشنه آشیل فعلی این فناوری میرسیم. وقتی یک مدل هوش مصنوعی ویدیویی میسازد که در آن لیوان از روی میز میافتد و میشکند، آیا واقعاً قوانین گرانش، شتاب و شکنندگی شیشه را درک کرده یا فقط به خاطر دیدن هزاران ویدیوی مشابه، یاد گرفته چه پیکسلهایی را کنار هم بگذارد تا نتیجه برای چشم ما باورپذیر باشد؟
در یک ویدیوی سرگرمی، اگر تکهای شیشه برخلاف قوانین فیزیک حرکت کند، اتفاقی نمیافتد. اما اگر یک ربات جراح یا خودروی خودران بر اساس درک غلط تصمیم بگیرد، نتیجه فاجعهبار خواهد بود.
گزارش تحقیقی رسانه Ars Technicaدر جولای ۲۰۲۶ که با پژوهشگران دانشگاه MIT، شرکت Runway و World Labs انجام شده، نشان میدهد صنعت فناوری هنوز حتی روی یک تعریف واحد از مدل جهانی توافق ندارد.
محققان دانشگاهها و مراکز علمی مثل دانشگاه «استنفورد» هم هشدار دادهاند که هیچ معیار و بنچمارک قابل اتکایی وجود ندارد که ثابت کند این مدلها برای استفاده در سیستمهای حساس و خطرناک امن هستند.
برای راستیآزمایی این سامانهها، متخصصان ناچارند از سه روش بهره ببرند
- سنجش آزمایشگاهی: مثلاً سقوط یک توپ را با حسگرهای دقیق ثبت کنند و ببینند آیا پیشبینی مدل با اعداد واقعی فیزیکی تطابق دارد یا فقط ظاهرش شبیه است.
- آزمایش مستقیم روی رباتهای فیزیکی: اگر برنامهای که مدل در شبیهسازی ریخته، در دنیای واقعی بارها شکست بخورد، یعنی مدل یک قانون فیزیکی مهم (مثل اصطکاک یا اینرسی) را جا انداخته است.
- برخورد با شرایط ناشناخته: مدل چقدر میتواند آموختههایش را به موادی تعمیم دهد که هرگز در دادههای آموزشی ندیده؟ اگر به جای چوب و فلز، مادهای ژلهای و چسبناک جلویش گذاشتیم، چه تصمیمی میگیرد؟
در پاسخ به این چالش گروهی از پژوهشگران بنچمارکی با نام WMEval معرفی کردند که مدلهای جهانی تعاملی را با استفاده از محیطهای شبیهسازی فیزیکی Unity ارزیابی میکند. مزیتش این است که کیفیت تصویر را بهتنهایی نمیسنجد؛ بلکه مدل را از نظر کنترلپذیری محیط، ثبات اشیا و شخصیتها، حرکت اجسام، رفتار مایعات و سازگاری با روابط علت و معلولی آزمایش میکند.
اگر پیشبینی مدل اشتباه از آب دربیاید چه میشود؟
بزرگترین کابوس در توسعه هوش فیزیکی، «توهم توأم با عمل» است. وقتی یک چتبات در نوشتن یک مقاله تاریخی گاف میدهد و رویدادی ساختگی سر هم میکند، متن را اصلاح میکنیم. اما اگر رباتی در انبار حدس بزند که یک قفسه نازک تحمل بار دویست کیلویی را دارد. ماشین نقشهای کاملاً منطقی را بر پایه یک فرضیه اشتباه اجرا میکند که نتیجهاش ویرانی قفسهها و مصدومیت کارکنان خواهد بود.
مسئله وقتی پیچیدهتر میشود که پای انسانها به میان بیاید. رفتار انسانها مثل قوانین حرکت نیوتن خطی و قابل پیشبینی نیست. مدل ممکن است محاسبه کند که یک رهگذر با همین گامهای یکنواخت به مسیرش ادامه خواهد داد، غافل از اینکه فرد ناگهان با دیدن دوستش در آن سوی خیابان، مسیر را کج میکند.
برای جلوگیری از این مشکلات دانشمندان روی دو سپر دفاعی کار میکنند
- تخمین عدم قطعیت: هوش مصنوعی باید یاد بگیرد که بگوید «نمیدانم» یا «مطمئن نیستم». اگر مدل نسبت به استحکام یک جعبه یا رفتار بعدی یک راننده دیگر شک دارد، به جای اصرار بر فرضیاتش، باید سرعت سیستم را کم کند، زاویه دیگری را بررسی کند یا کلاً از انجام کار پر ریسک دست بکشد.
- سیستمهای ایمنی مستقل: در کارهای پرخطر، تصمیم نهایی هرگز نباید فقط به عهده همان مدلی باشد که شبیهسازی را انجام داده است. سنسورهای فیزیکی مجزا، محدودکنندههای مکانیکی و سیستمهای کنترلی کلاسیک باید مثل یک ناظر مستقل بالای سر هوش مصنوعی باشند تا اگر پیشبینی مدل غلط بود، جلوی فاجعه را بگیرند.
ترکیب زبان و عمل: پازل آینده چطور کامل میشود؟
سرمایهگذاری سنگین گوگل، انویدیا و متا روی مدلهای جهانی به این معنی نیست که دوره مدلهای زبانی (LLM) به سر آمده. آینده متعلق به ترکیب این دو فناوری است.
در سیستمهای هوشمند آینده، مدل زبانی نقش «بخش ارتباطات و برنامهریزی کلان» را بازی میکند و مدل جهانی نقش «درک فیزیکی و شبیهسازی» را برعهده میگیرد. وقتی به یک ربات خانگی بگویید: «میز ناهارخوری را جمع کن»، این اتفاق میافتد
- مدل زبانی دستور را میفهمد و آن را به مراحل کوچکتر تقسیم میکند (برداشتن بشقابها، بردن به آشپزخانه، دستمال کشیدن میز).
- مدل جهانی میز را میبیند و عواقب فیزیکی هر حرکت را شبیهسازی میکند (اگر بشقاب زیرین را بکشم، لیوان رویی میافتد؛ پس اول باید لیوان را بردارم).
- سیستم کنترلی ربات این نقشه امن را به دستورات حرکتی برای موتورها و مفاصل ربات تبدیل میکند.
جهش بزرگ بعدی در دنیای هوش مصنوعی زمانی رخ میدهد که ماشینی بتواند وارد یک محیط ناآشنا شود، قوانین حاکم بر اشیا آن را بفهمد، قبل از هر حرکتی عواقب آن را بسنجد، خطرات را تشخیص دهد و وظیفهای را به سرانجام برساند. برای اینکه هوش مصنوعی در محیط فیزیکی کمک دستمان شود، درک قوانین فیزیک به اندازه فهمیدن زبان بشر حیاتی است.
برای ارزیابی پایداری، امنیت و نگهداری این زیرساخت، راهنمای پشتیبانی شبکه را نیز مطالعه کنید.